首先,我们要旗帜鲜明地表态:标题的这个说法,我们是完全不认可的。
其次,我们承认有点“标题党”了。但相信,看完这篇文章,各位就能够原谅我们。毕竟在下面两篇自媒体文章的攻势之下,也许“只有魔法能够打败魔法”。
在展开讨论之前,我们先把结论放在这里:完整的“居民身份证号”,一律应当识别为敏感个人信息。
太长不看版
01 “身份证等证件不再整体视为敏感个人信息”?真的吗,我不信
02 从法律上看,“身份证号”必须是“敏感个人信息”
03 从损害结果上看,个人和企业都承受不起“身份证号”泄露的后果
04 身份证号一般不会单独收集,数据汇聚会让风险进一步扩大
05 企业处理“身份证号”的最佳实践
欢迎添加文末微信号,获取《中国人工智能法规及政策汇编》
1.
“身份证等证件不再整体视为敏感个人信息”?真的吗,我不信。
最近,这两个帖子火了:
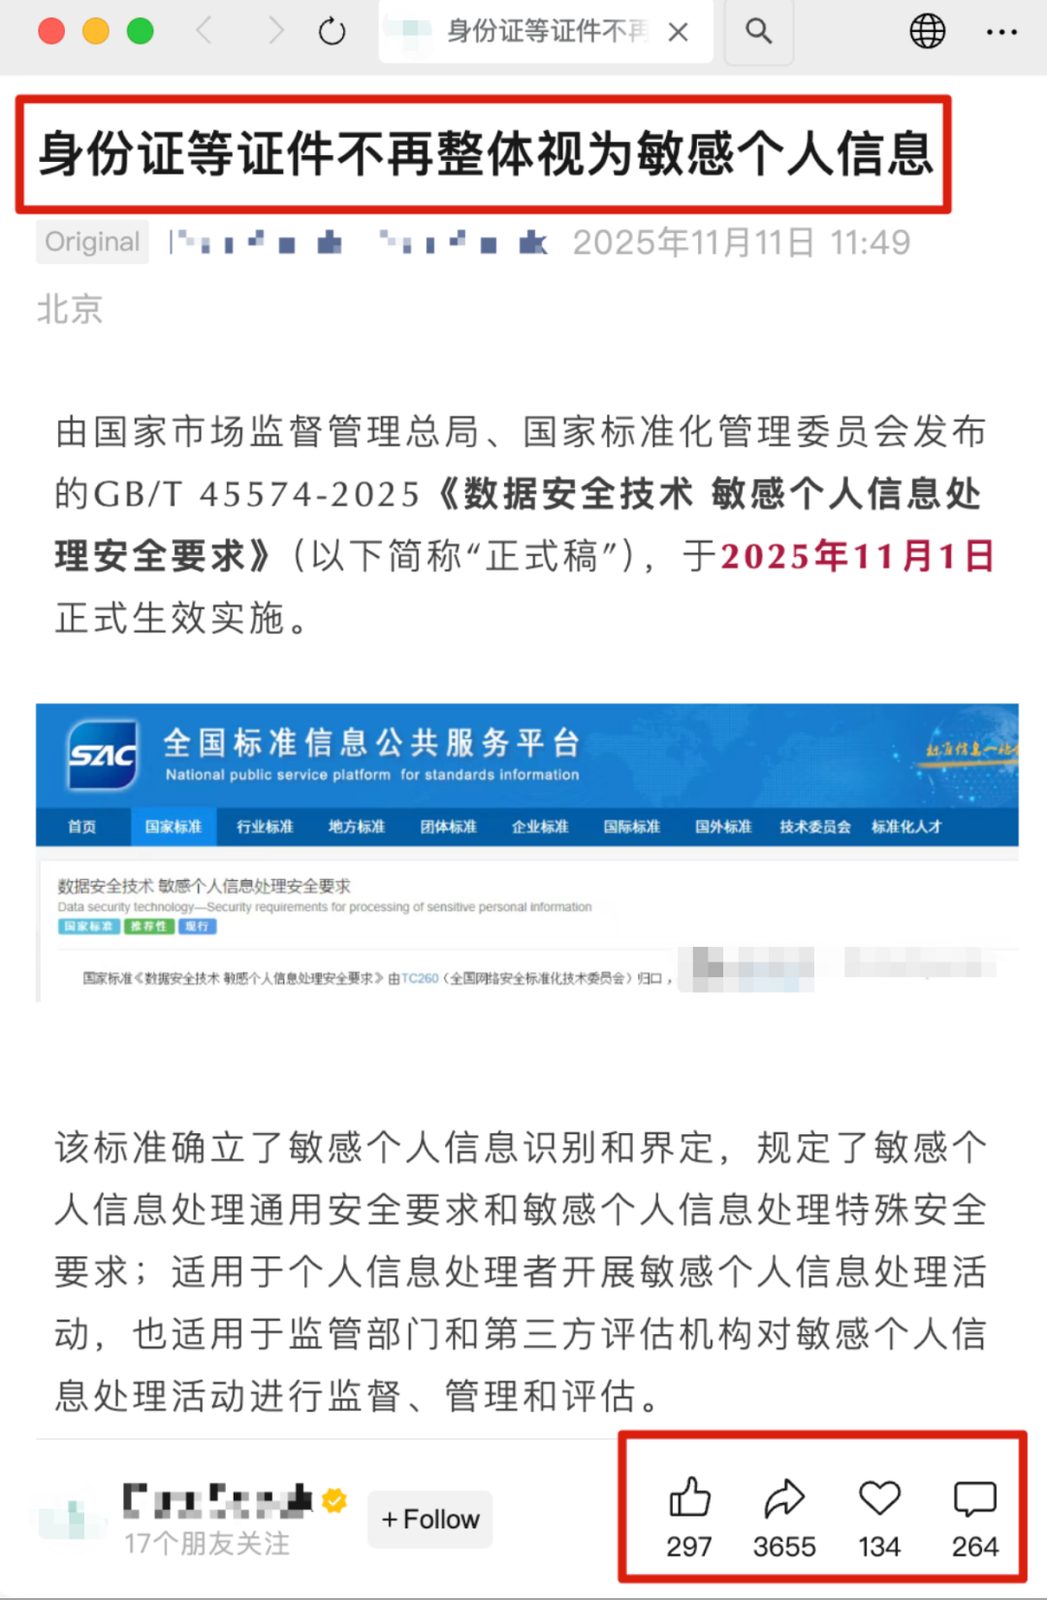
该公众号文章总阅读量近10万
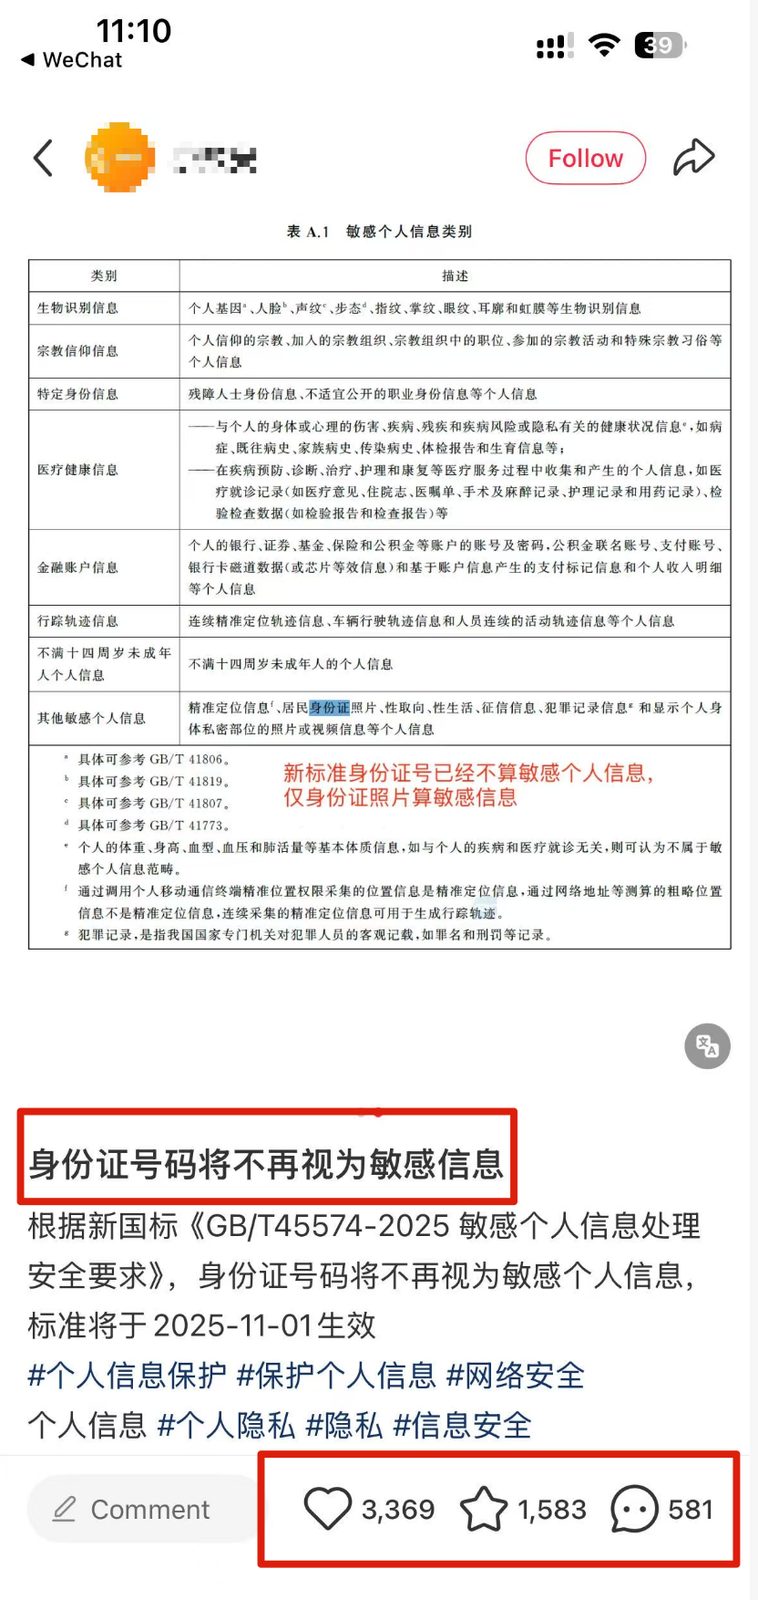
小某书爆款截图,截止文章发布,阅读量还在增加,评论区吃瓜群众情绪化表达严重
事情的起因是这样的:
11月1日起,GB/T 45574-2025《数据安全技术 敏感个人信息处理安全要求》(下文称“45574”)正式生效。该国标有几个引人瞩目的要点:
作为一个名为《敏感个人信息处理安全要求》的全新国标。无论其正文还是附录,45574都没有将“身份证号”,识别为“敏感个人信息”;
与之相比,“居民身份证照片”却在45574的附录A中,被列入“其他敏感个人信息”的类别。据此可推:既然只有承载了更多信息(含姓名、年龄、民族、地址、身份证号等)的“居民身份证照片”,才能被识别为“敏感个人信息”,那么单独的身份证号,自然有理有据地被排除在“敏感个人信息”之外;
不仅如此,在45574国标的征求意见稿中,身份证件号码被归类到敏感个人信息类别下,但在正式稿中却不见踪影。
基于这些理由,出现“身份证号码不再被视为敏感个人信息”的观点,似乎情有可原。
然而,随着舆论的发酵,以及45574的正式生效,企业在数据处理时,产生了真实的困境:
公司手里的“居民身份证号”,到底还要不要当做“敏感个人信息”来进行保护?
如果身份证号不再是敏感个人信息,那么《个人信息保护法》中规定的各项合规义务,都可以省略了:单独同意和告知不用做了、个人信息保护影响评估(下称“PIA”)不用做了、跨境传输的限制没有了、安全保护义务减少了、数据交易更加丝滑了……
这对企业来说,简直是重大利好。
但是事实,真的有这么“美好”吗?
1.
从法律上看,“身份证号”必须是“敏感个人信息”
1 敏感个人信息的定义
《个人信息保护法》和45574对敏感个人信息的定义一致,均为:
“敏感个人信息是一旦泄露或者非法使用,容易导致自然人的人格尊严受到侵害或者人身、财产安全受到危害的个人信息,包括生物识别、宗教信仰、特定身份、医疗健康、金融账户、行踪轨迹等信息,以及不满十四周岁未成年人的个人信息。”
尽管45574的附录没有将身份证号列入这几类敏感个人信息类别,但从个保法和45574的规定看,仅凭“身份证号未被列举”这一点,并不能得出“身份证号不是敏感个人信息”的结论。
实际上,从附录中的“等”(列举+兜底式条款)、“资料性附录”(附录是资料性,举例之用,非强制)等表达方式,都无法直接得出“身份证号不是敏感个人信息”的结论。
关于这方面的具体论述,公众号「网安寻路人」在《敏感个人信息的界定和范围出现实质性变化了吗?》已有详尽阐释,大家可以跳转查阅。
2 敏感个人信息的判断
就我们的经验而言,判断具体某一个字段是否属于“敏感个人信息”,大致可以遵循以下流程:
描述场景/字段→套用定义进行判断→核对标准→基于场景和定义做出判断
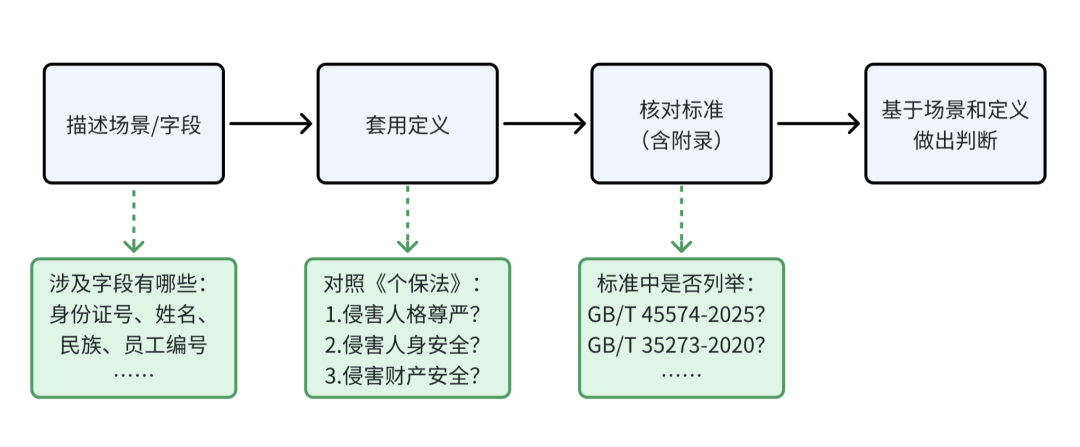
此处有两点需要注意:
从定义的角度上看,泄露身份证号将会产生严重的后果。下文会重点进行阐述和举例;
从标准适用的角度上看,35273和45574并非替代关系。
在流程图中,我们提到了2020年生效的GB/T 35273《信息安全技术 个人信息安全规范》(本文简称“35273”)。其实在45574颁布前,行业内对于居民身份证号是否属于“敏感个人信息”基本没有争议。
原因很简单,作为数据领域影响力最大(可能没有“之一”)的推荐性国家标准,35273对于身份证号是否属于敏感个人信息的问题认定,几乎有着一锤定音的效果:
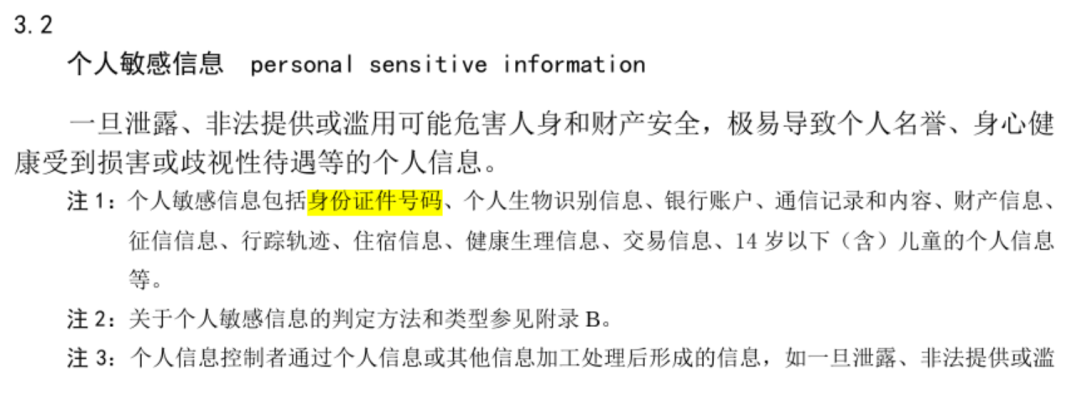
补充:35273明确将身份证号列入“个人敏感信息”。另,因《个保法》出台,业内已统一称之为“敏感个信息”,二者概念相同,不存在歧义
同样作为推荐性国标,35273与45574之间,并未产生替代的作用。在45574没有明确表示排除对身份证号的识别的情况下,35273仍能作为“敏感个信息”的识别依据或参考。
可见,无论是基于定义本身,还是参照标准进行识别,对“身份证号是否属于敏感个人信息”的判断标准,并未发生变化。
3 身份证号上承载大量的个人信息
根据GB 11643-1999《公民身份证号码》的规定,身份证号码是一组具有特定含义的组合编码。该标准规定的身份证号码的编码规则如下:
-前六位为地址码:精确对应公民常住户口所在地的县级行政区划
随后八位出生日期码:完整记录公民的年月日信息
接下来的三位为顺序码:用于对同一地区同一日出生的人员进行区分,其中顺序码的奇偶性直接对应性别标识
-最后一位校验码:采用ISO7064:1983,MOD11-2校验码系统,系根据前十七位计算得出
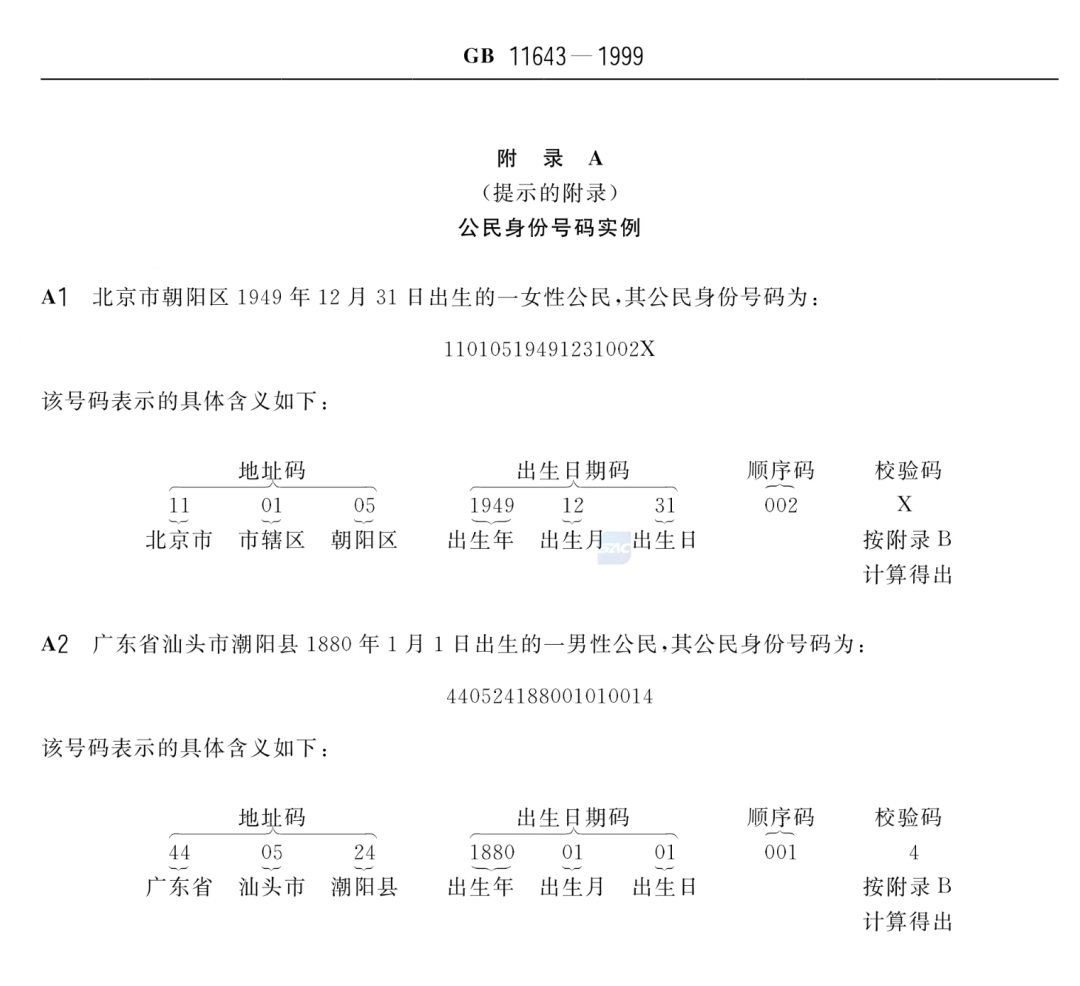
这种高度结构化的设计意味着,只要有人获取了完整正确的身份证号码,就能够直接识别到这个身份证号中所包含的户籍地、精确出生日期及性别这三项核心身份要素。
这些信息的泄露,无疑会给个人信息主体带来人格尊严和人身、财产上的严重危害。
1.
从损害结果上看,个人和企业都承受不起“身份证号”泄露的后果
1 身份证号的用途广泛
《中华人民共和国居民身份证法》第三条规定,公民身份号码是每个公民唯一的、终身不变的身份代码。
身份证号的不可变更、强身份识别和应用范围广等特性,使其在所有个人信息中占据着独一无二的地位。
在很多合法查询个人信息的场景(比如通过姓名+身份证号的组合查询失信被执行人信息),身份证号都是重要索引,用于调取数据库中对应的个人信息。
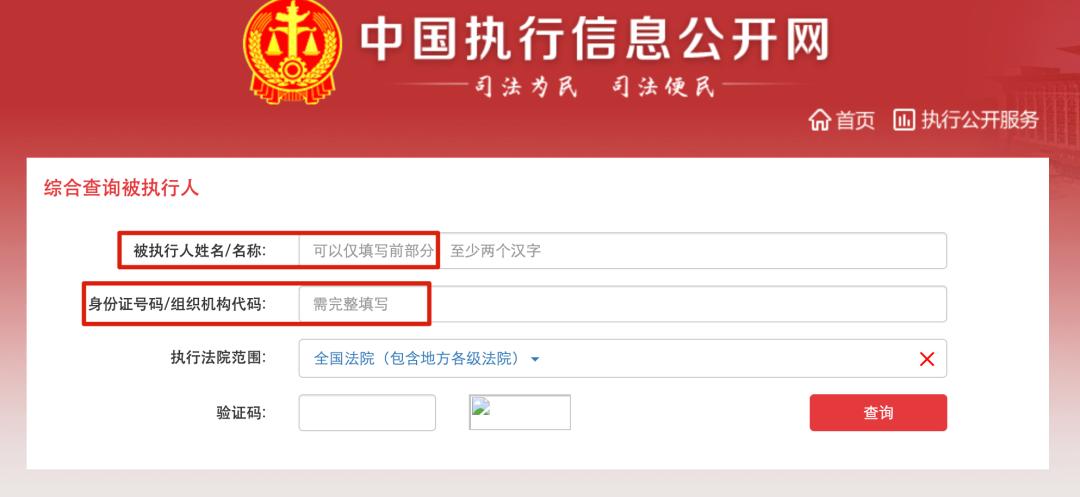
在执行信息公开网中,身份证号码必须被准确填写;而个人姓名只需要填写部分
而在非法查询个人信息的场景下,身份证号泄露的破坏力更是不容小觑。比如前段时间的“开盒”事件,就给涉事个人信息主体带来严重的困扰。
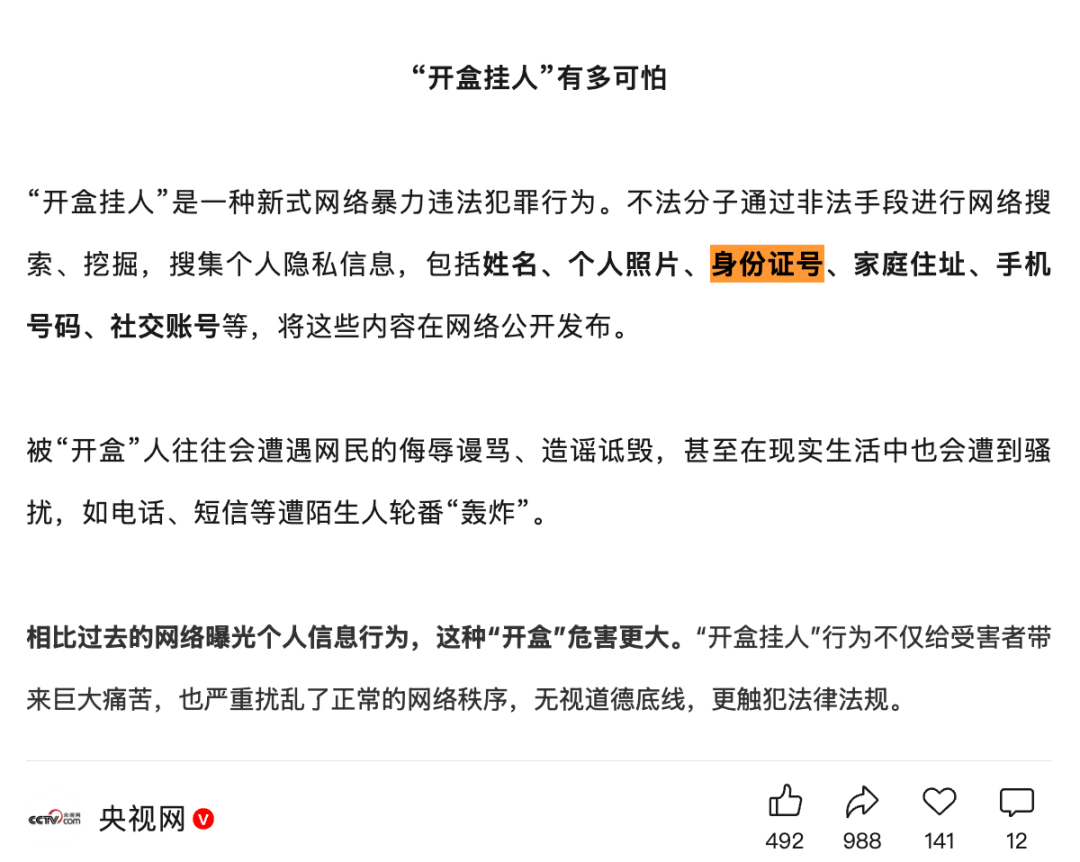
央视网下场点评“开盒”事件
明星因为身份证号泄露带来困扰的情形也相当常见:
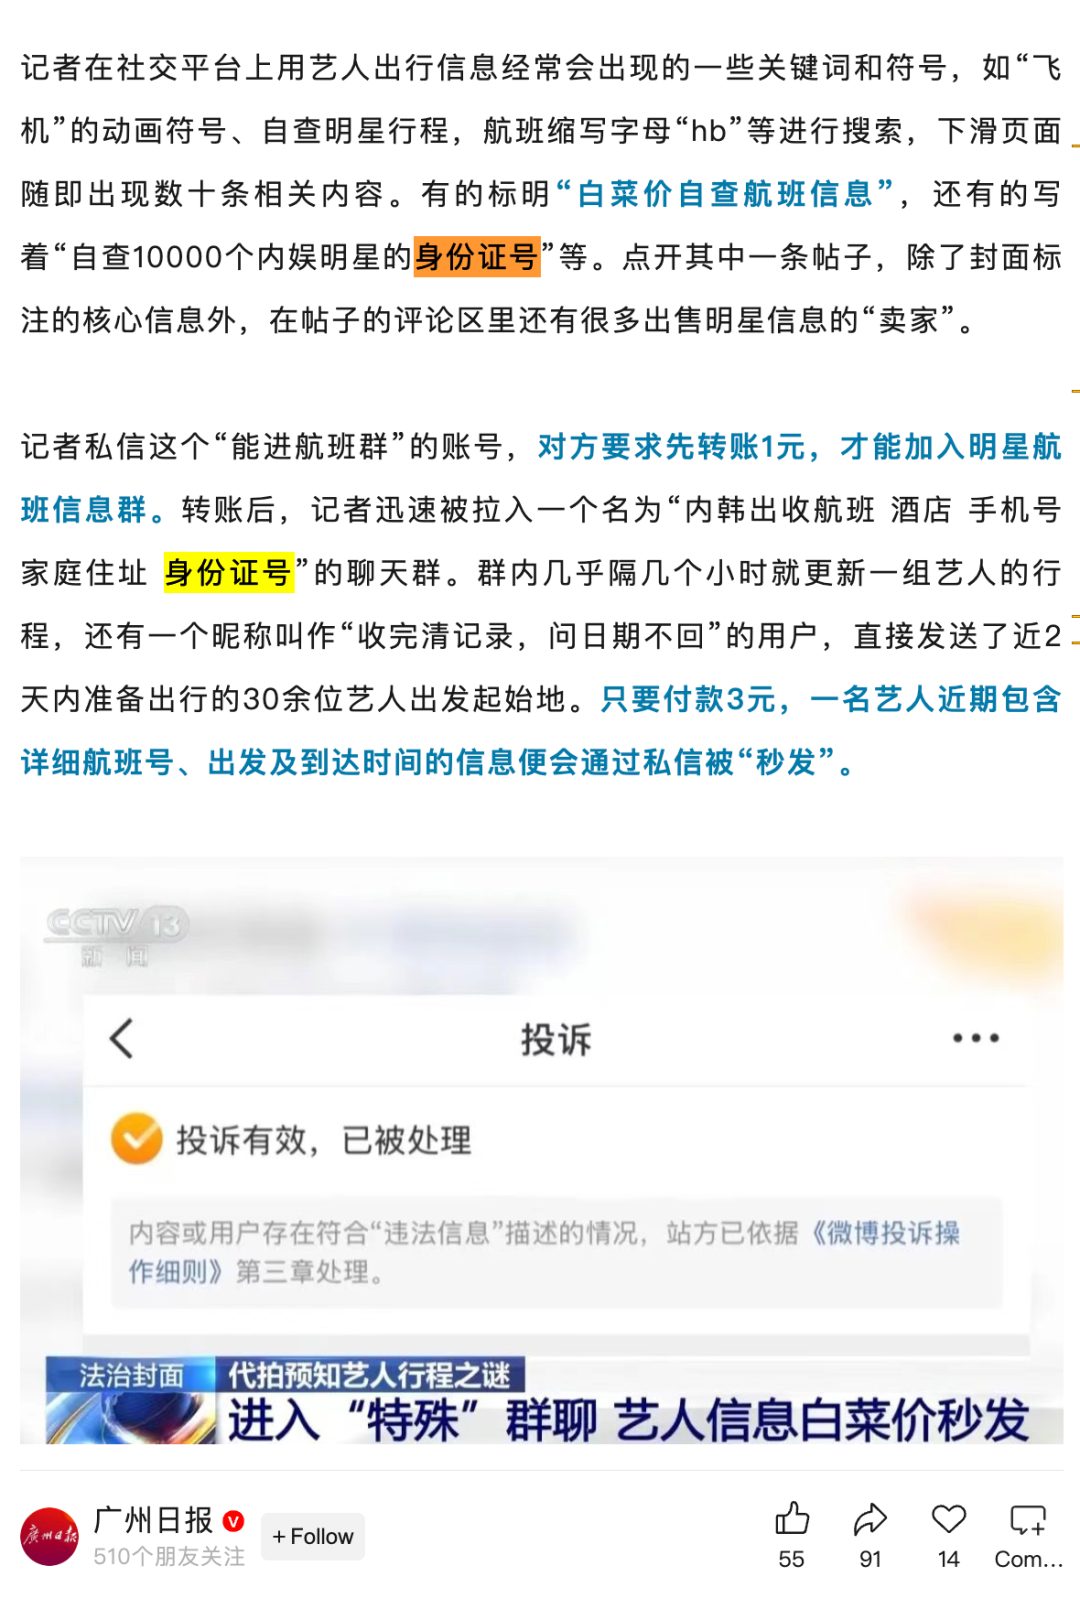
2 身份证号泄露,容易导致数据和财产泄露
生活中存在着大量使用身份证后6位或者后4位登录各类账号的场景:
①为提升效率,很多企事业单位往往会采用“完整身份证号码”或者“手机号”作为账号、“身份证后6位”为登录密码的方式,方便用户首次登录。
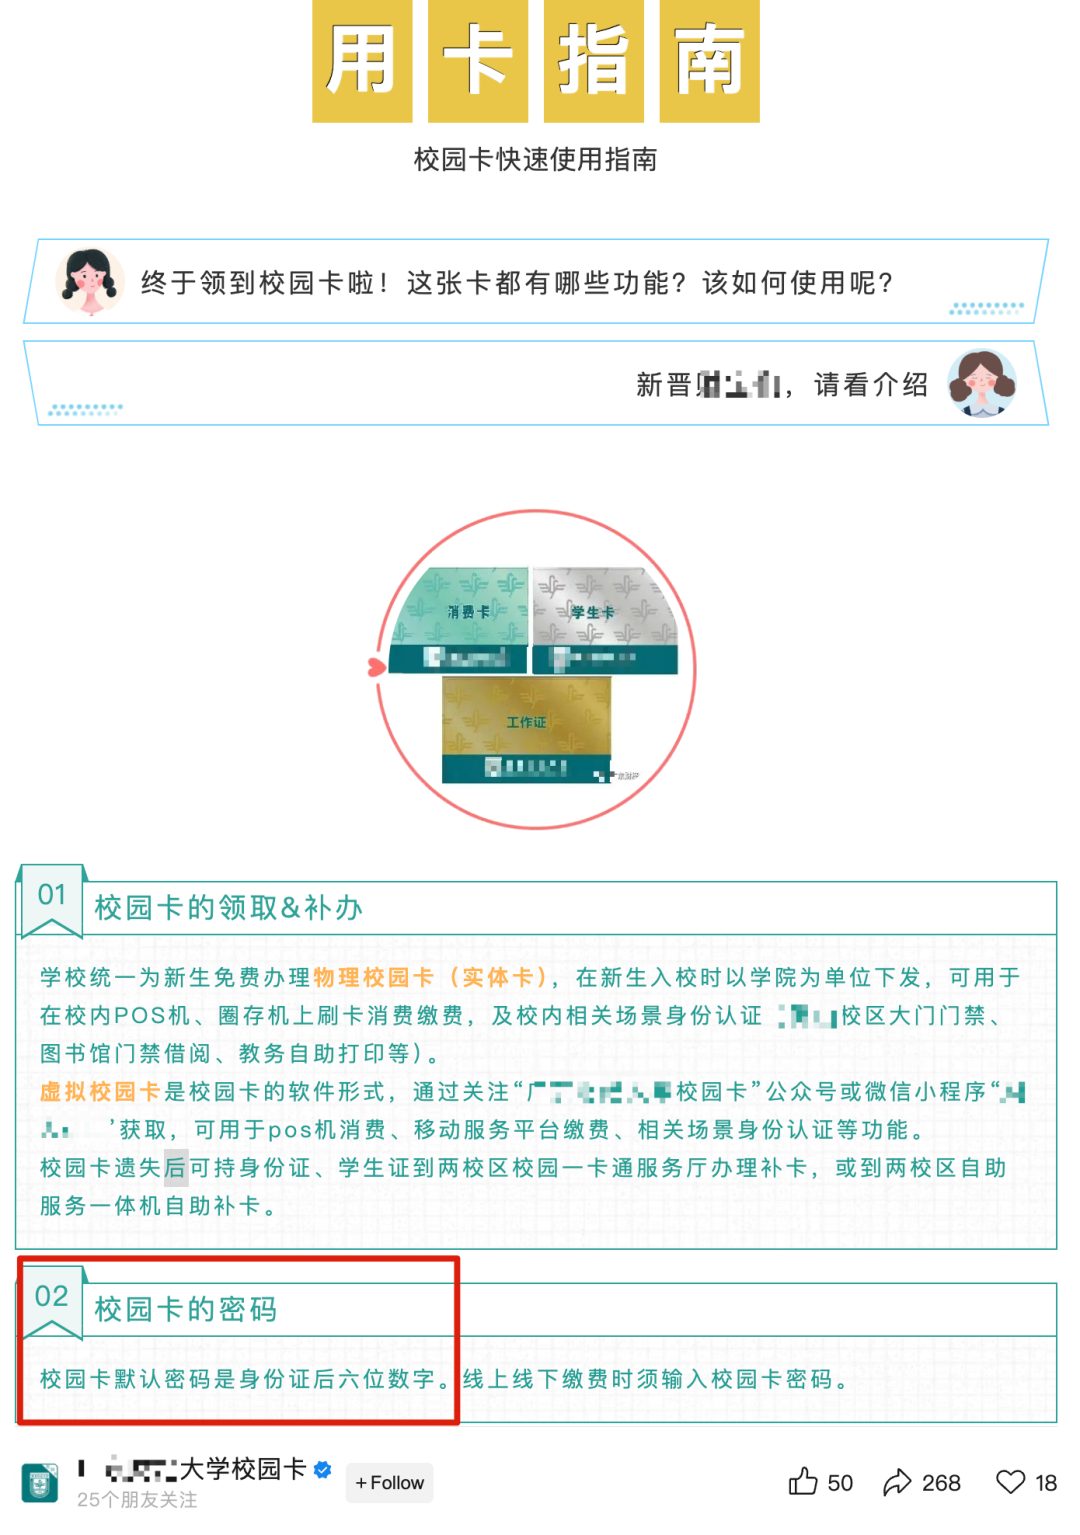
②某些大学在发放学生卡时,会将身份证号后六位设为系统的初始登录密码。虽然校方往往会提示学生修改密码,但因管理不严、学生的个人信息保护意识不足、贪图便利等原因,账号主体继续沿用初始密码的情形比比皆是。在这种场景下,学生个人信息乃至个人财产,都有受到侵害的风险。
③法律行业自身也难以幸免:
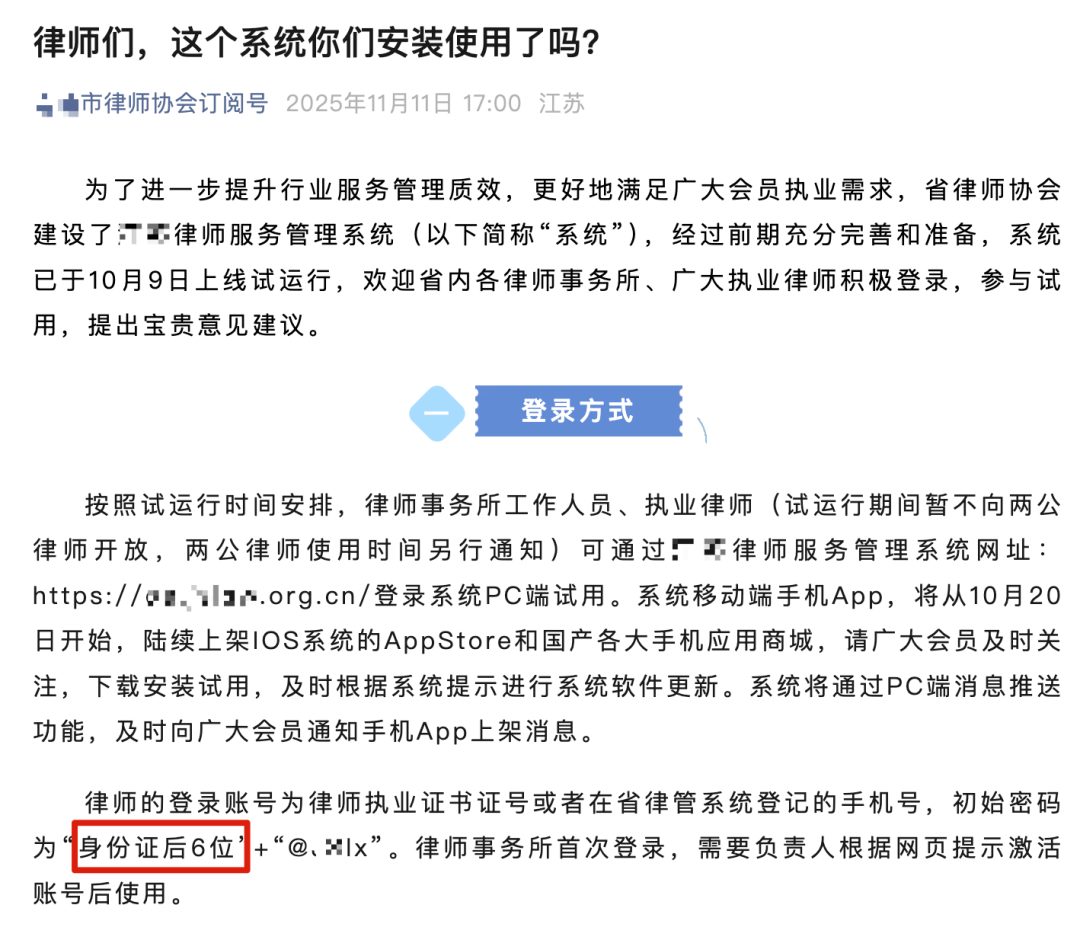
(一边写文章一边搜索,看到这两张截图时心里想着:欢迎各家学校和律协,找我们做个PIA……)
以上场景,只是身份证号泄露危害的冰山一角;但已充分证明,身份证号本身的敏感性,并不是“标准附录中没有列举”可以消弭的。
1.
身份证号一般不会单独收集,数据汇聚会让风险进一步扩大
看到这里,不知道还有多少人还坚持认为——“45574修改了身份证号的敏感个人信息属性”。
如果还是保持这个观点,我只能说:不理解但尊重。
为了更进一步提醒各位注意这项重大风险,我们再注意一下45574规定下的另一种情形:
“4.1敏感个人信息识别”的c)项规定:
既要考虑单项敏感个人信息识别,也要考虑多项一般个人信息汇聚后的整体属性,分析其一旦泄露或非法使用可能对个人权益造成的影响,如符合a)所述条件,应将汇聚后的个人信息整体参照敏感个人信息进行识别与保护。
言下之意:就算你认为单项身份证号不足以构成敏感个人信息,也要考虑是否存在多项个人信息汇聚后,其整体应当被识别为敏感个人信息的情形。
我们说得更直白一些:收集、存储、加工个人信息的企业,有哪家是将“身份证号”这项个人信息单独处理的?
实际上,企业处理身份证号的同时,几乎必然需要处理个人信息主体的其他个人信息,比如姓名、手机号、住址等。这些信息如果与身份证号结合,往往可以“扒光”个人信息主体的各项隐私,造成更加严重的人身和财产损失。
如果你还认为这不属于敏感个人信息,那我们只能继续表示尊重……
所以,就算我们不去纠结45574的法律解释,仅从数据处理实务的角度去看,身份证号这项个人信息,仍然会因为极其容易与其他个人信息汇聚,而整体被识别为敏感个人信息。
在当前的监管态度下,企业还是小心谨慎为宜。
1.
企业处理“身份证号”的最佳实践
基于我们的经验,我们认为在可预见的未来里,数据合规既没有尽头,也没有满分答卷。为了帮助企业更好地处理身份证号这类敏感个人信息,我们提出以下几个建议:
场景化识别
不管是身份证号还是其他敏感个人信息,都要放回到场景里,对涉及到的字段信息进行分析。既要考虑数据处理的目的,又要考虑数据来源和数据处理的合法性,还要考虑单项、多项个人信息的汇聚的敏感程度,以及这些个人信息泄露可能导致的后果。
尤其是,如果不收集这些个人信息,也能达到相同的数据处理目的和效果,那就更应该果断删除累赘的字段,降低风险、提高效率。
对数据进行脱敏
在很多场景下,身份证号最主要的功能是身份识别。但身份识别不一定需要精确的身份证号。
举个例子,在一些数据集规模较小数据库里,将身份证号的部分字符进行遮挡,结合个人信息主体的姓氏,也可以完成身份核验。
例如,某校的在校学生只有数千人,用“王*强”+“440524*\*\*\*\*\*\*\*\*\*14”这样的组合,也完全可以识别出王某的身份。
那么在数据库里,可以只存储脱敏后的个人信息,降低个人信息泄露的风险。充分利用“去标识化后应作为一般个人信息进行保护”“匿名化处理后不是个人信息”这类制度设计。
PIA流程化
根据《个人信息保护法》第55条的规定,处理敏感个人信息需要进行“个人信息保护影响评估”(也就是PIA)。由于PIA是事前评估,这意味着每次新增一项处理敏感个人信息的业务,都需要做一次PIA,企业往往不堪重负。
但企业完全可以将PIA流程化。如果企业本身已经具备了PIA的专业水平,也不需要外部律师来进行辅导或签字,则完全可以做一套针对PIA的SOP,通过模板化评估表、预设风险等级和自动化报告生成,将PIA嵌入产品开发与数据流转的每个关键节点。
用成熟的“套路”,来回应法律和监管的需求,既确保合规可控,又避免重复劳动。
其他的合规义务,法律和国家标准说了很多。篇幅有限,我们就不过多展开。
最后想说的是,数据合规观念的普及,还有一条漫长的道路要走。情绪化的表达容易带来流量,却也容易把企业的数据合规带到沟里去。
某些大号先发一篇流量爆文吸引眼球,再发一篇“昨天我说错了”,却任由原来的推文继续传播错误的观点,甚至污染了AI……
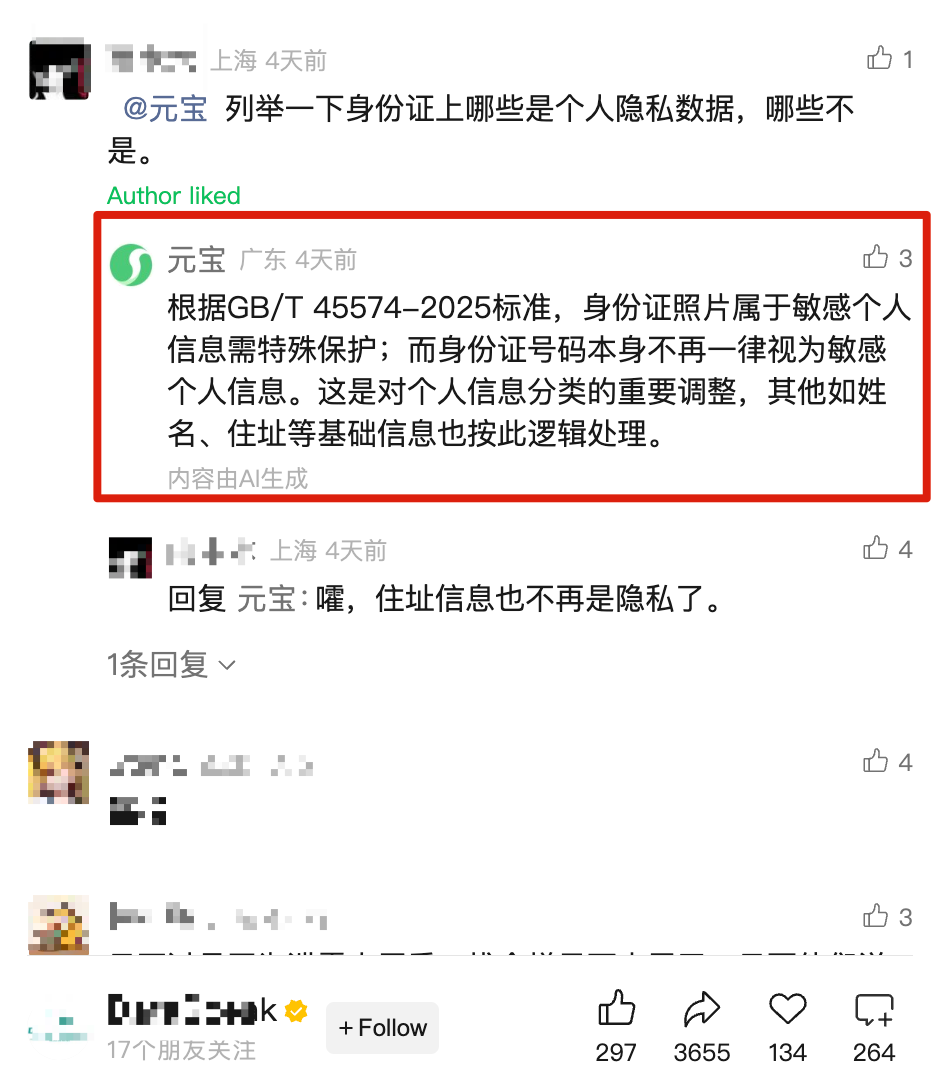
评论区@出来的AI,也不出意外地被带偏
这实在是一种不负责任的做法。
35273正在修订中,希望出台的版本,不要再横跳了:在敏感个人信息的正文或附录里干干净净地把身份证号列上去,继续一锤定音吧。
先谢了。
— END — 作者 /陈焕律师 李琪瑶律师 余问甄
审核/ 陈焕律师 李琪瑶律师
编辑/ 余问甄
作者简介
陈焕
《法律人必备AI必备核心技能》《法律人ChatGPT应用指南》作者,北京市隆安(广州)律师事务所律师、隆安全国合规委副主任、隆安湾区人工智能法律研究中心主任、广东省人工智能产业协会法律专业委员会主任、广州市律协协会数据与数字经济委秘书长、广东财经大学法学院人工智能法研究中心兼职研究员、广州数据交易所入库数据合规辅导师、广州市涉外律师领军人才。擅长人工智能、数据合规、GDPR、网络安全、计算机网络犯罪等事务。
李琪瑶
《法律人必备AI必备核心技能》编者,AI合规圈负责人,英语专业八级,现为北京市隆安(广州)律师事务所律师,广州数据交易所入库数据合规辅导师、隆安湾区人工智能法律研究中心研究员、隆安广州制裁和双反专业委员会专家顾问。李琪瑶律师擅长人工智能、数据合规、知识产权诉讼和非诉业务、民商事争议解决事务。
欢迎添加微信,获取《中国人工智能法规及政策汇编》
双十一,手可以剁,但千万不可以抖2.0
法律不保护AI提示词?上海法院判了
深度比对|都是AI模型训练平台,为何杭州的“奥特曼”赔了,上海的“美杜莎”不用赔?