(图片由AI生成)
LinkedIn未经同意使用用户数据训练AI
9月18日,国外媒体报道,多位LinkedIn用户注意到LinkedIn正在使用用户的数据来训练他们的人工智能大模型。当天,LinkedIn也在《用户协议》及《隐私政策》中更新了与LinkedIn提供的生成式人工智能功能相关的条款。
LinkedIn的法律顾问BlakeLawit在LinkedIn中表明,LinkedIn将使用用户数据进行生成式人工智能训练,同时提供了退出(Opt-out)设置,澄清将不会对来自欧洲经济区、瑞士和英国的用户数据进行生成式人工智能训练。
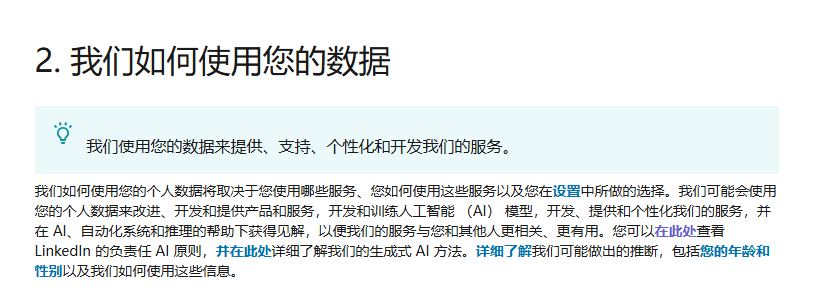
(LinkedIn更新后的《隐私政策》)
此前英国开放权利组织(Open Rights Group,简称ORG)曾向英国信息专员办公室(Information Commissioner’s Office,简称ICO)投诉LinkedIn未经同意擅自使用用户数据进行人工智能训练,而在LinkedIn更新隐私政策后,英国ICO也确认LinkedIn已采取措施停止使用英国用户的数据用于模型训练。
LinkedIn将如何在生成式人工智能中使用用户数据
根据LinkedIn官网展示的LinkedIn与生成式人工智能的常见问题,LinkedIn整理如下:
1.LinkedIn是否使用用户的个人数据用于生成式人工智能?
LinkedIn在提供服务时收集并使用用户数据,具体包括用户对AI模型或AI功能的使用情况、用户的帖子、文章、使用频率、语言偏好以及向LinkedIn提交的反馈等用户数据,并依据隐私政策改进或开发服务。目前,LinkedIn明确不使用来自欧盟、欧洲经济区、英国或瑞士会员的数据训练AI模型。
LinkedIn结合具体业务场景进一步解释,当用户在使用LinkedIn的人工智能时,如输入了姓名等个人信息,则人工智能在输出时可能包含用户输入的个人信息。此外,用户使用LinkedIn的部分功能时也也会涉及对用户数据的处理。例如,当用户使用LinkedIn的“个人简历撰写建议”功能,LinkedIn将使用或处理用户个人档案上的相关数据来生成建议文本,用户可以查看、编辑并决定是否将其添加到用户的个人档案中。
2.LinkedIn是否使用用户的个人数据来训练AI?
对于这个问题,LinkedIn并未否认。LinkedIn表示,他们在训练生成式人工智能模型时,将尽量减少用于训练模型的数据集中的个人数据,包括使用隐私增强技术来编辑或删除训练数据集中的个人数据。同时强调LinkedIn目前不会使用欧盟、欧洲经济区、英国或瑞士用户的数据来训练内容生成人工智能模型。
3.用户是否可以选择不使用用户个人数据和用户自行创建的内容来训练LinkedIn的人工智能模型?
在这个问题上,LinkedIn针对不同地区的用户采取了不同的做法:
(1)针对位于欧盟、欧洲经济区、英国或瑞士的LinkedIn用户:LinkedIn不提供退出选项,默认不使用该等地区用户的数据进行大模型训练。
(2)针对上述地区之外的其他LinkedIn用户:用户可以在设置中选择退出,确认不再将自己的数据及创建内容用于LinkedIn的模型训练(包括模型微调)。当用户选择退出后,LinkedIn及其附属机构日后将不会使用用户在LinkedIn上的个人数据或内容来训练模型,但不会影响已经进行的模型训练。
除上述规定外,用户还可以通过LinkedIn的数据处理异议表,对将其个人数据用于训练非内容生成式的人工智能模型提出异议。
4.用户使用LinkedIn的人工智能生成功能时,LinkedIn会使用或处理哪些个人数据?
例如,当用户使用LinkedIn的“个人简历撰写建议”等人工智能生成功能时,LinkedIn会处理用户与该功能的交互数据,其中可能包括个人数据(例如用户的输入和结果输出、用户的使用信息、用户的语言偏好以及用户提供的任何反馈等)。关于LinkedIn如何处理个人数据,可以查阅LinkedIn的《隐私政策》。
5.LinkedIn对于用户与人工智能的对话内容将保存多长时间?
当用户使用LinkedIn上的生成式AI功能时,用户提供的信息和生成的任何内容都将由LinkedIn保存,直至用户删除为止。如果用户想查找过去的对话,或者只是想了解LinkedIn所拥有的用户相关的个人数据,用户可以使用LinkedIn的数据访问工具来查看LinkedIn所拥有的关于用户在LinkedIn上的数据,同时用户可以删除或请求删除。
LinkedIn并非个例
使用用户数据进行模型训练一直是一个极具争议的问题。尽管LinkedIn已经更新了隐私政策,但在LinkedIn之前,已有不少互联网巨头采取了该方式来悄悄使用用户数据训练大模型。
Facebook和Instagram曾更新隐私政策,以使用用户发布的帖子、图片或在线跟踪数据来训练Meta AI模型。今年早些时候,在引起ICO担忧后,Meta为此停止使用英国Facebook和 Instagram的数据,但近期Meta又重启使用用户数据训练AI。我国近两年也曾发生类似事件,一些人工智能企业未经同意使用用户数据训练模型而引发舆论风波和用户担忧。
未来,企业想使用用户数据训练自有模型,宜采取更为审慎、透明且合规的途径,避免在无声中行动,否则可能招致加剧的用户批评与审查监管。
作者简介
陈 焕 律师
陈焕律师,《法律人ChatGPT应用指南》作者,北京市隆安(广州)律师事务所律师、隆安湾区人工智能法律研究中心主任、隆安广州数字经济部副部长、广东财经大学法学院人工智能法研究中心兼职研究员、国家工业信息安全发展研究中心《生成式人工智能数据应用合规指南》标准起草人、广州市涉外律师领军人才。
李琪瑶 律师
李琪瑶律师,英语专业八级。现为北京市隆安(广州)律师事务所律师,隆安湾区人工智能法律研究中心研究员。李琪瑶律师擅长人工智能、数据合规、知识产权诉讼和非诉业务、民商事争议解决事务。
---
往期文章推荐:
人工智能
加州通过两项法案,保护演员的肖像不被AI模仿
任天堂与宝可梦公司对《幻兽帕鲁》提起专利诉讼
《人工智能生成合成内容标识办法(征求意见稿)》公开征求意见的通知http://mp.weixin.qq.com/s?\_\_biz=MzAxMDc0ODY5Mg==&mid=2247485447&idx=1&sn=c60ec7d503c410ba89354196a4fc80f1&chksm=9b4ade7cac3d576adce5559b3e8cfeee0134a73aded5edc72b11b1b791ba31ae998564f18c8b&scene=21#wechat_redirect
中国人工智能监管及政策文件汇编
重磅:网安标委颁布《人工智能安全治理框架》1.0版
最新消息:理想已经报警。AI云诊产品有哪些合规要点?
赛博“照妖镜”:AI魑魅的标识与辨别
秘塔AI:完蛋!我们收到了知网28页的侵权告知函http://mp.weixin.qq.com/s?\_\_biz=MzAxMDc0ODY5Mg==&mid=2247485274&idx=1&sn=034cd253b62141eee8dee891f3e7031d&chksm=9b4ad121ac3d5837f35fa0dcd633afa466b0748df362437b24079a62bcdf23ef93e188d89707&scene=21#wechat_redirect
检察院发文提示人工智能合规问题 | 企业如何防控刑事风险
律师测评 | 用户创建AI虚拟人角色,平台有哪些责任?
寡姐要告OpenAI:律师评山寨名人声音的商业模式
律师测评 | ChatGPT-4o,让人机之恋走进现实
AI生成声音第一案,给AIGC创业项目的3点教训
律师评测 | 华为手机“AI一键脱衣”
数字经济
写在3季度结束前:已有41家上市公司披露数据资源入表情况
最新发布:粤港澳大湾区(内地、澳门)个人信息跨境流动标准合同实施指引
人民法院报:虚拟货币司法处置须规范化http://mp.weixin.qq.com/s?\_\_biz=MzAxMDc0ODY5Mg==&mid=2247485363&idx=1&sn=a8cf92b97ca7c8b230c4fdf81d0b1cb7&chksm=9b4ad1c8ac3d58de19d812d002cfce9db1f70f7ff70f05d4755e0daabd0b67d50fa664f84dd7&scene=21#wechat_redirect
数据资产 | 公交领域数据入表案例盘点与分析
限期实缴制下出资新方式探索——数据“入表+入股”是否具有可行性?
数据资产新篇章丨隆安广州“数据资源入表实战沙龙”在南沙圆满落幕
数据资产|对企业而言,数据资源入表有6大价值
数据产权规定汇编|国家数据局将推出8项制度文件,涉及人工智能和数据产权
---
《法律人ChatGPT应用指南》,可直接点击下图购买: