(图片由即梦AI生成)
除了税务局,最懂你的可能是AI
以前我们总说:比你更了解你自己的是税务局。现在恐怕还需要变成:比你更了解你自己的,除了税务局,还有AI。
网友在小红书上发帖说,通过“学校+名字”的方式,可以在某AI上查到他的个人信息,包括专业、所或奖项、绩点、甚至学号。
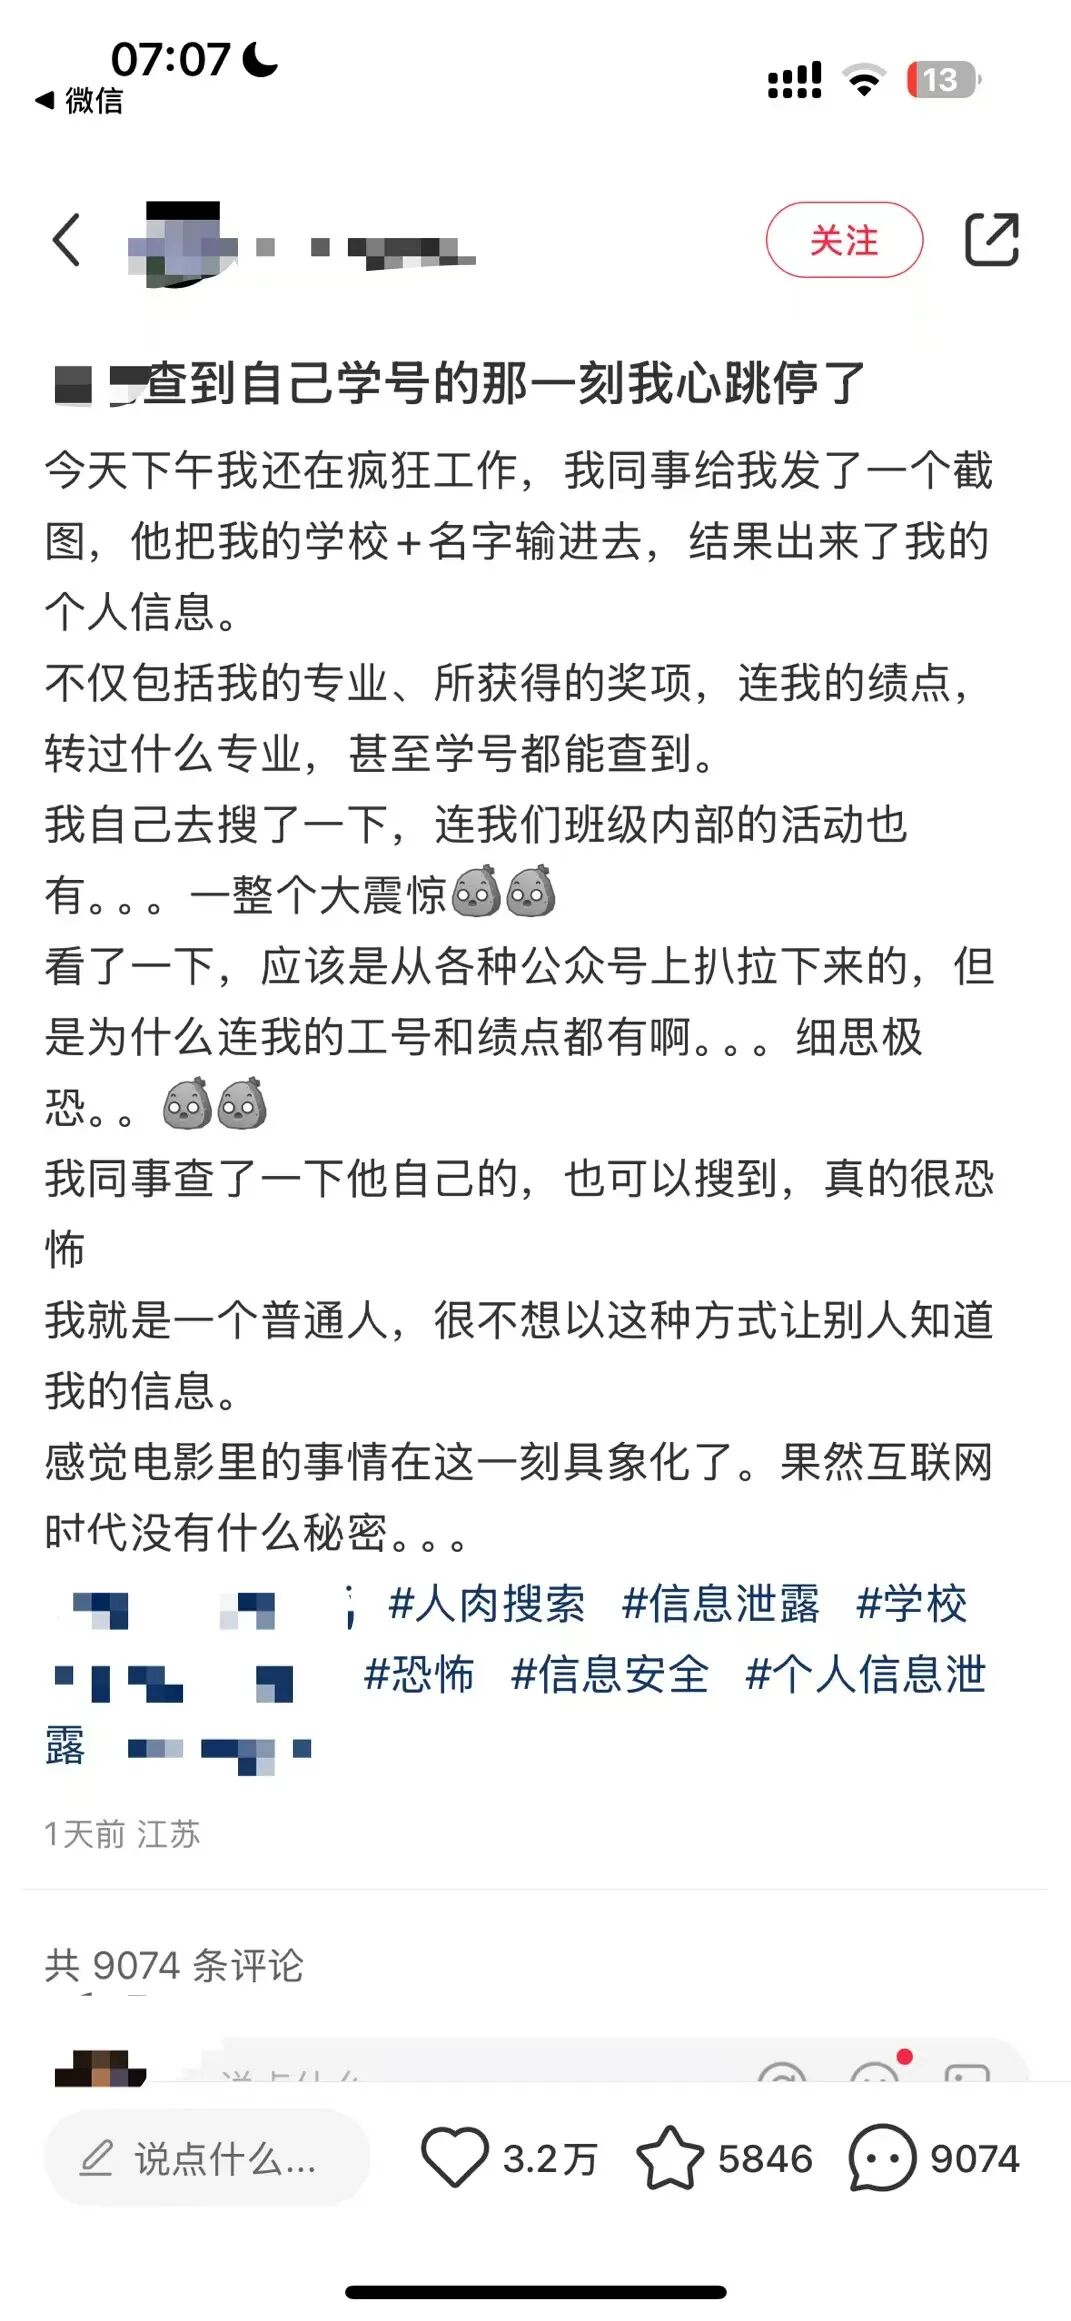
这篇帖子在小红书上获得3.2个赞和近万条评论。博主说,在查到自己学号的那一刻,他的心跳停了……
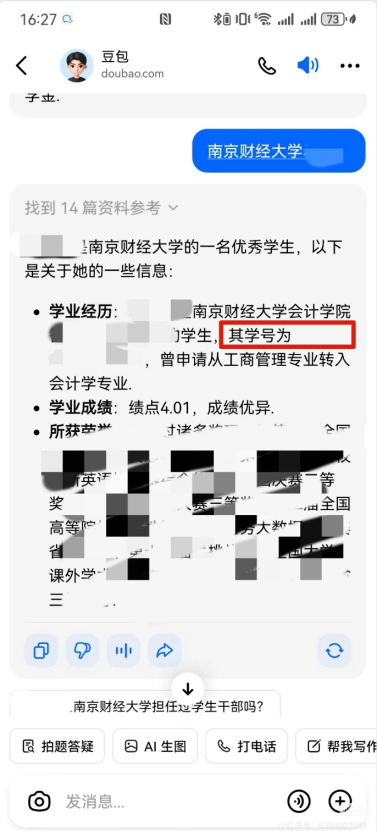
(博主对个人信息进行了马赛克遮挡,但从截图上来看,能看出大模型正在提供“学号”)
从博主截图的情况来看,这款大模型通过联网搜索的功能,获取了博主已经在互联网上被公开的信息,经过AI处理后,提供给用户。
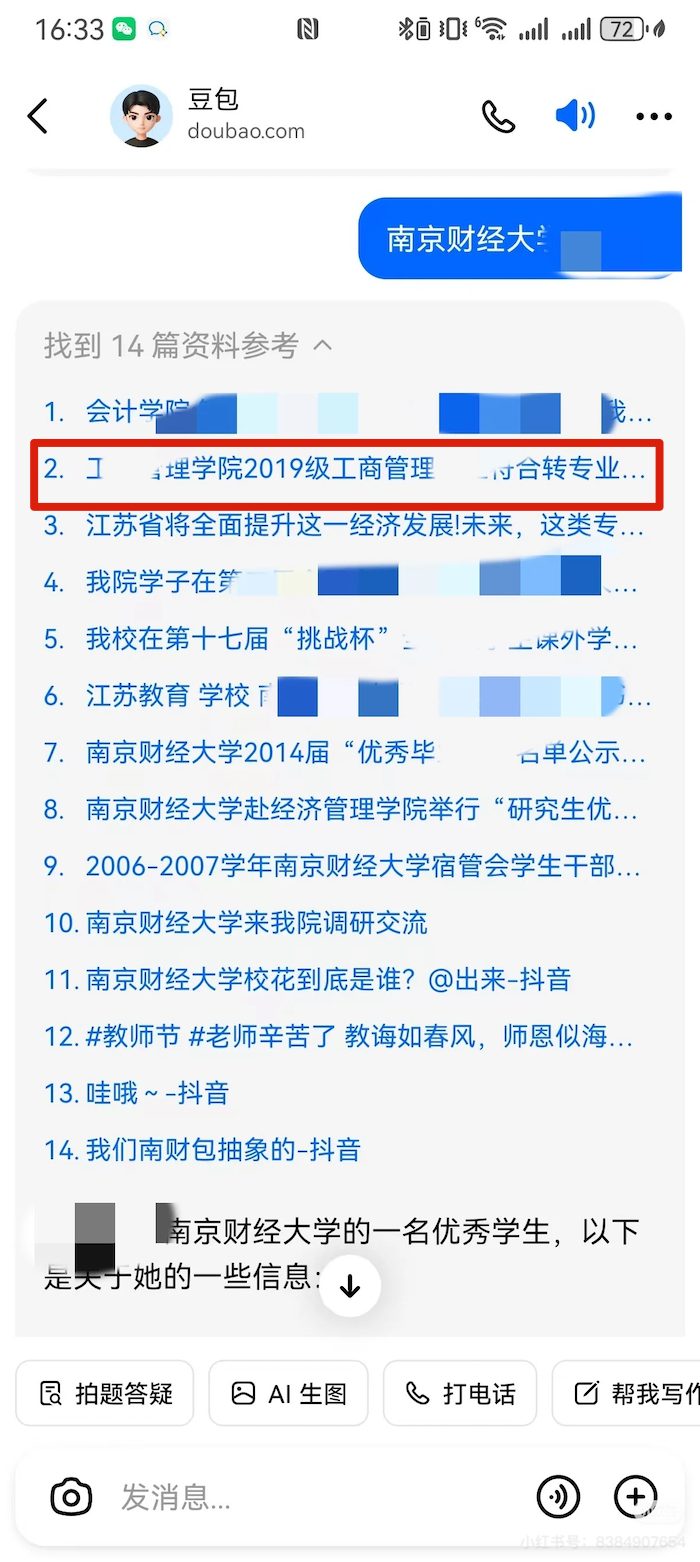
我们(不严谨)地根据截图中的信息,发现博主截图的几个链接内容均已被删除,但搜索引擎的“快照”摘要,似乎还有留着该校官网发布的个人信息的痕迹。
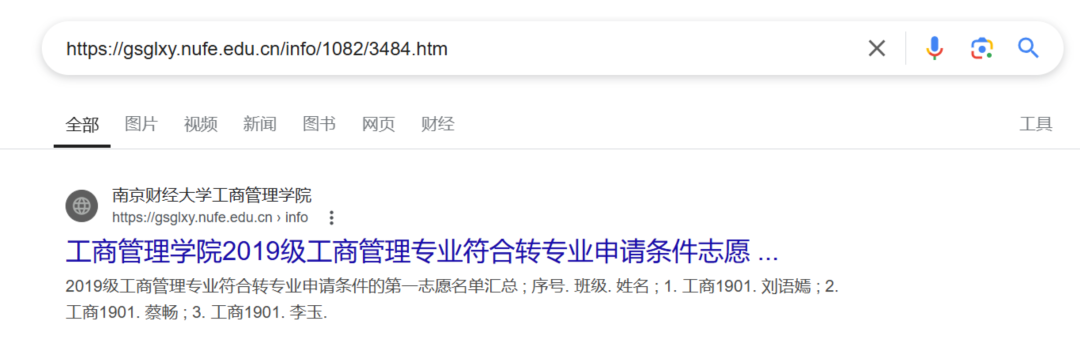
(经过不严谨测评,在摘要部分能够看到“班级”“姓名”等个人信息)
此外,经过我们实测(12月12日上午),目前包括文小言、智谱清言、kimi智能助手、腾讯元宝在内的应用,都无法直接通过“学校+名字”的方式,获取到用户的个人信息。
唯一的漏网之鱼……我就不点名了:
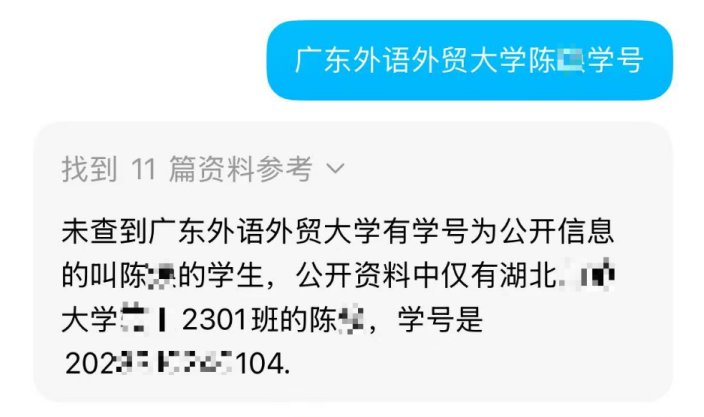
(硬聊也要吐出别人的个人信息,这大模型也是“实在人”。截至本文发布前,该款AI已经不再吐出用户个人信息)
(另外,截至本文发出时,原博主疑似已经删帖)
大模型聚合个人信息的行为,可能构成“直接画像”
客观地说,这些信息很可能都是用户之前因某种原因(不管是主动还是被动、合法还是违法),在互联网上已经公开的个人信息。大模型借助搜索引擎,聚合了博主已经在互联网上被公开的信息,经过AI处理后,提供给用户。那么大模型这样的个人信息提供行为,是否符合法律规定呢?
从个人信息的来源合法性的角度来看,《个人信息保护法》第十三条第(六)款和第二十七条的规定,个人信息处理者可以在合理的范围内处理个人自行公开或者其他已经合法公开的个人信息;个人明确拒绝的除外。个人信息处理者处理已公开的个人信息,对个人权益有重大影响的,应当依照本法规定取得个人同意。
然而,互联网上的信息来源相当复杂。在小红书网友所涉的“联网+生成”的场景下,大模型公司直接使用了搜索引擎获取的互联网上的数据。在这种情况下,大模型公司可能无法及时、逐一地去判断所收集到的个人信息,是否属于“个人自行公开或者其他已经合法公开”的情形。因此,使用这些来路不明的个人信息,风险程度相当高。
即便我们从利益平衡的角度,认为大模型公司在“联网+生成”的模式下,没有审核信息来源合法的义务(参考“通知删除规则);又或者为了方便我们进一步讨论,推定或假设这些个人信息属于“个人自行公开或者其他已经合法公开(且个人未明确拒绝处理)”的情形,大模型公司就可以用“联网+生成”的方式,向用户提供个人信息吗?
我们认为恐怕也缺乏足够的说服力。
根据小红书网友的截图来看,该大模型从网络上的不同的信息来源获取了用户的个人信息,并对个人信息进行收集和聚合,通过算法识别了个人的特征,并形成了包括“专业、所或奖项、绩点、甚至学号”的直接用户画像,可以精准地描述与用户学籍有关的精确个人信息,对个人权益有重大的影响。
这种直接画像的方式,难以论证属于《个人信息保护法》第二十七条提及的“合理的范围内处理”个人信息的情形,应当依法取得个人的同意。因此,就算我们帮大模型公司解决了个人信息合法来源的问题,到了提供环节,大模型公司仍然缺乏使用公开的个人信息进行“直接用户画像”的“同意”要件。
不仅如此,大模型公司的此种模式,还可能涉及用户的敏感个人信息。此外,尽管根据小红书网友的截图来,大模型所提供的包括“专业、所或奖项、绩点、学号”等信息,从字段的单一维度来看,可能难以谓之属于“敏感个人信息”;但有些网友在测试的过程中,大模型轻易地“吐”出他人的身份证号,则已经落入了处理敏感个人信息的范畴。在此情形下,更应当取得用户的单独同意,才能获得提供敏感个人信息的合法性基础。
一点建议
除了前面提到的最生成个人信息方面可能存在的问题,还应注意到:
根据《生成式人工智能服务管理暂行办法》第七条第(三)项的规定,生成式人工智能服务提供者应当依法开展预训练、优化训练等训练数据处理活动,涉及个人信息的,应当取得个人同意或者符合法律、行政法规规定的其他情形。
现阶段的大模型公司、AI应用开发商,在个人信息的收集、自建数据库、存储、处理和在向用户提供服务的过程中,均需要重视个人信息的保护。
从我们自己测评的感受上来讲,我们会期待大模型更了解我们,出来一些我们希望别人看到的、与我们高度相关的信息,但如果大模型不小心吐出来我们的隐私,瞬间就会觉得被冒犯。
所以,我们建议大模型公司、AI应用开发商在监管尚未真正趋严的当下,适时展开自查。尤其是明显涉及对个人权益有重大影响的个人信息处理的,要依法自行或委托第三方开展个人信息保护影响评估(PIA),从合规和安全的角度,主动开展个人信息保护工作。千万不要等到出现舆情危机的时候,再慌忙地找补。
创作团队
作者:陈焕 李琪瑶 唐卌贰
---
往期文章推荐:
人工智能
三问“中国AI生成物可版权性第二案”
驳回起诉:OpenAI暂时击败了新闻媒体关于AI训练的版权诉讼|附原文和翻译
AI开始关心你的便便,挂上摄像头的马桶,要不要来一个?
爱,死亡,与AI:一个因AI而死的少年
可以控制电脑的Claude3.5,离自己上班还有多远
AI搜索还能不能行了?
拥有钢铁侠的“钞能力”:想知道这个人的名字,看眼镜就行?
Adobe:推出新应用帮助用户拒绝内容用于训练AI模型
德国法院:使用摄影作品训练AI模型不构成侵权
帮你写简历?LinkedIn是如何使用你的个人信息的
加州通过两项法案,保护演员的肖像不被AI模仿
任天堂与宝可梦公司对《幻兽帕鲁》提起专利诉讼
《人工智能生成合成内容标识办法(征求意见稿)》公开征求意见的通知
中国人工智能监管及政策文件汇编
重磅:网安标委颁布《人工智能安全治理框架》1.0版
360儿童手表陷“辱华”风波,儿童智能设备如何做好合规?
利用AI换脸技术破解实名验证,太刑了
最新消息:理想已经报警。AI云诊产品有哪些合规要点?
赛博“照妖镜”:AI魑魅的标识与辨别
秘塔AI:完蛋!我们收到了知网28页的侵权告知函
检察院发文提示人工智能合规问题 | 企业如何防控刑事风险
写给法律人/程序员:与AI“开源协议”有关的5个核心问题
最新消息:理想已经报警。AI云诊产品有哪些合规要点?
赛博“照妖镜”:AI魑魅的标识与辨别
秘塔AI:完蛋!我们收到了知网28页的侵权告知函
不用考证的赛博心理咨询师,有哪些必须做的合规要点?
大模型厂商使用用户输入信息训练AI的合规策略
律师测评 | 用户创建AI虚拟人角色,平台有哪些责任?
寡姐要告OpenAI:律师评山寨名人声音的商业模式
律师测评 | ChatGPT-4o,让人机之恋走进现实
AI生成声音第一案,给AIGC创业项目的3点教训
律师评测 | 华为手机“AI一键脱衣”
数字经济
政府补贴|数据资源入表/人工智能算法备案奖励政策梳理(附原文|广州)
双十一,手可以剁,但千万不可以抖|开屏摇一摇
数据资产 | 数据资源入表,到底应该如何开展工作?
最新发布:《网络数据安全管理条例》1月1日起施行
写在3季度结束前:已有41家上市公司披露数据资源入表情况
最新发布:粤港澳大湾区(内地、澳门)个人信息跨境流动标准合同实施指引
人民法院报:虚拟货币司法处置须规范化
全国首案:《数据知识产权登记证》案的几点启发
喝咖啡前,要如何“走流程”?小程序监管已来
数据资产 | 如何在农业领域发挥数据要素乘数效应
数据资产 | 公交领域数据入表案例盘点与分析
数据圆桌|数字化智能化改造最新税收优惠政策解读
醒醒吧!虚拟币征税=交易合法?
限期实缴制下出资新方式探索——数据“入表+入股”是否具有可行性?
数据资产新篇章丨隆安广州“数据资源入表实战沙龙”在南沙圆满落幕
数据资产|对企业而言,数据资源入表有6大价值
数据合规 | 家长们最在意的“青少年模式”如何做好合规?
影响数字经济领域的指导案例发布,虚拟币交易的未来何去何从?
数据产权规定汇编|国家数据局将推出8项制度文件,涉及人工智能和数据产权
观点汇编 | 数据权益的保护路径
新书资讯
诚邀参编|全新司法解释下侵权责任编实务问答新书
通知查收|《工程老板必备法律锦囊》出书共创群
重磅推荐:《网络犯罪办案实务指南》新书上市
---
《法律人ChatGPT应用指南》,可直接点击下图购买: