2023年1月13日,Sarah Anderson、Kelly McKernan和Karla Ortiz三名艺术家作为代表,一纸状告了Stability AI、Midjourney两家大型的人工智能公司以及知名艺术社区DeviantArt。该案于7月19日举行了听证会。10月30日,William Orrick法官作出裁决,驳回了除Sarah Anderson对Stability Al直接侵权诉请之外原告的其他诉讼请求,但同时给予原告修改诉状中不足之处的机会。在本案中,三位艺术家将两类被告、三个主体杂糅在一起起诉,在诉讼策略上可能并不是最优解,案件的结果也对原告方不利。所以我们将不会遵循判决书的顺序来归纳要点,仅主观地摘取部分有趣的角度来进行讨论。
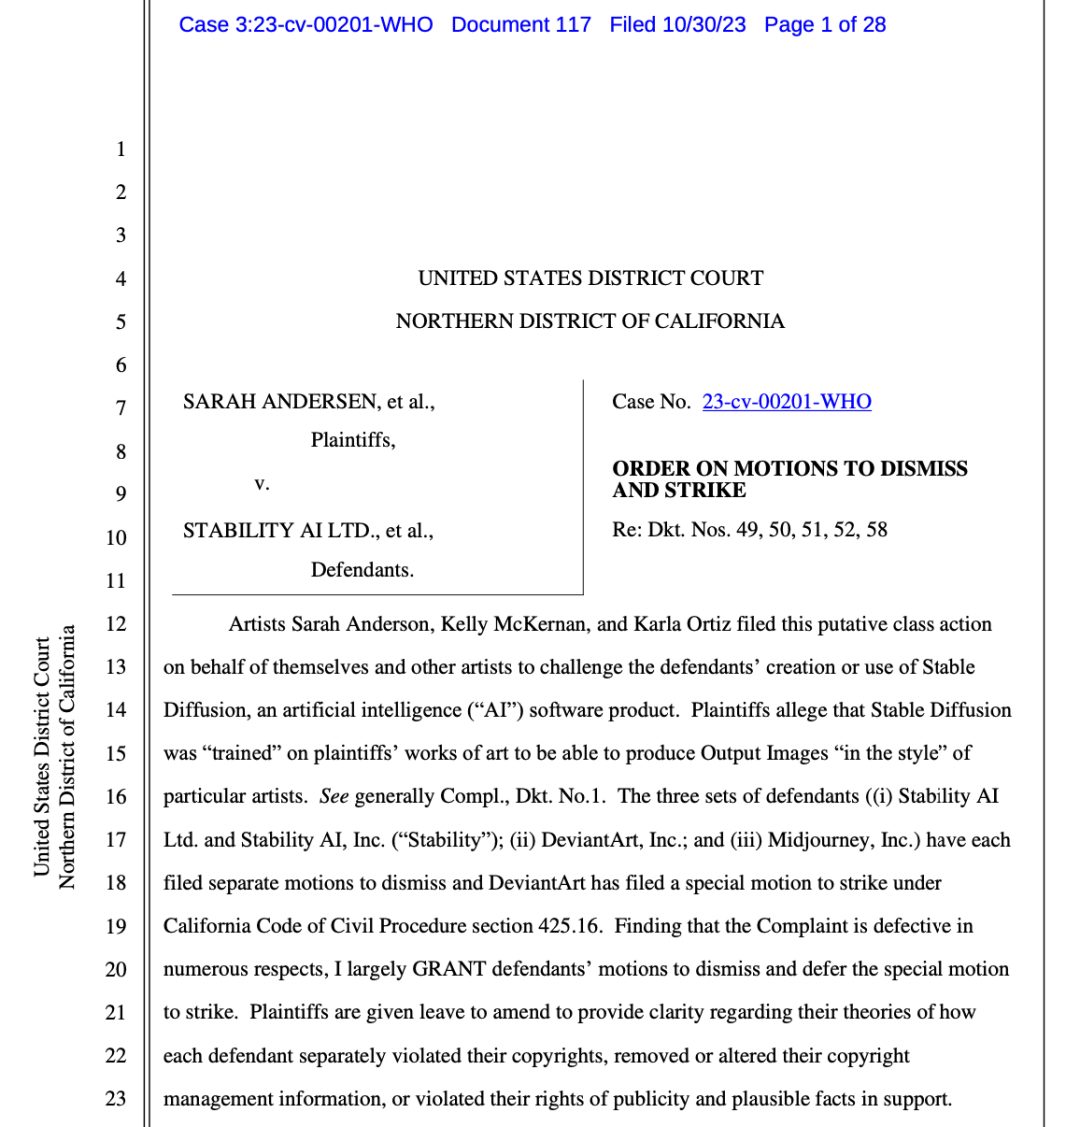
(对判决原文感兴趣的读者,可以在公众号后台留言“SD”,获取判决书原文。)
Stability AI等公司是否使用了艺术家的作品进行训练?
1.原告主张:被告“搜刮”大量的数据+存储“压缩副本”。
原告在诉状中将Stable Diffusion描述为“21世纪的拼贴工具”,原文是这样说的:AI IMAGE GENERATORS ARE 21ST-CENTURY COLLAGE TOOLS THAT VIOLATE THE RIGHTS OF MILLIONS OF ARTISTS. (AI图像生成器是21世纪的拼贴工具,侵犯了数百万艺术家的权利。)
原告声称,人工智能模型的发展,除了依赖科学技术的进步,也离不开大量的数据来训练模型。而被告在未获得权利人的许可或给予报酬的情况下,“搜刮”大量图像用于模型训练,并以压缩副本(compressed copies)的方式将大量受版权保护的图像储存在Stable Diffusion中,用于训练Stable Diffusion。同时,原告还认为Stable Diffusion模型每次生成的结果都构成侵权的衍生作品(美国版权法保护作者制作“衍生”作品,即在原作品的基础上创作的其他作品等权利)。
2.法院裁定:允许修改诉状、补充取证。
法院未直接驳回原告对Stability公司的侵权索赔,而是要求原告修改其诉状中的不明确之处,并提供更多的证据支撑。法院认为,原告并没有在其诉状中明确说明Stable Diffusion是否存储了训练图像的实际副本(如压缩的JPEG文件),还是使用了能够重建这些图像的算法,指明除非原告在技术原理上能够讲明模型是如何复制其作品的,否则难以支持原告的该项主张。
模型支持用户生成某个艺术家风格的图像,是否侵犯艺术家的商品化权?
1.原告主张:侵犯了商品化权
形象权(Right of Publicity),指的是个人对其肖像、姓名、声音、及其他个人特征的控制权,形象权制度的主要目的在于保护个人对姓名、肖像、声音等人身元素在商业上的使用权益。
本案原告认为,包括原告在内的众多艺术家的姓名,与其各自的艺术风格存在一定的联系,而被告在其AI产品中,支持用户根据原告的姓名来生成对应艺术风格的图像,被告盗用原告的姓名进行商业运营,原告等艺术家的姓名对被告盈利贡献巨大。
2.法院:驳回,但允许补充举证
但由于原告未能就该项主张进行举证,无法证明被告的产品如何使用原告的姓名,如何导致与原告名字相关的商誉受损,法院最终也驳回了原告的该项主张。
尽管原告的该项诉请被驳回,但如原告能够举证证明被告在他们的人工智能产品中商业性使用原告的姓名,则被告有可能构成对原告商品化权的侵犯。
艺术作品展示平台DeviantArt是否违反了用户协议,是对艺术家的“背叛”?
1.原告对DeviantArt的控诉:未经许可使用作品
DeviantArt是一个支持艺术家在线分享作品的社区平台,拥有数百万张图像。而Dreamup是DeviantArt基于Stable Diffusion模型开发的一款付费产品。
原告认为:
一方面,DeviantArt和Stability一样,没有针对模型训练图像获得权利人许可,也没有向权利人分享其产品收入。
另一方面,DeviantArt的服务条款允许爬虫在某些情况下进行数据爬取,为Stable Diffusion及其他AI产品爬取DeviantArt的图像提供了便利,DeviantArt违反了自己的服务条款中“禁止将网站内容用于任何商业目的”的服务条款,已对平台的艺术家作构成不正当竞争。
2.法院:驳回,但允许修改诉状
法院还是驳回了原告对DeviantArt直接侵权的诉讼请求,并允许其修改诉状。理由是原告无法明确指出DeviantArt违反了哪一条条款,未能提供充分的证据来证明DeviantArt是如何侵犯原告的权利。
尽管原告的该项诉请未得到支持,但对于像DeviantArt这样的大型艺术家作品展示社区平台,如在未经艺术家许可的情况下,允许模型爬取其平台的作品用于模型训练,则有可能构成对平台用户协议的违约(在用户协议条款有相关禁止条款的前提下),同时也可能构成对作品权利人的侵权。
与本案有关的一些思考
1.原告的“压缩副本”理论是否正确?是否必要?
首先我们先看看原告是如何主张“Stable Diffusion将对训练图像进行复制或存储”的?
原告引用了数篇论文:
(1)一篇是来自斯坦福大学Jascha Sohl-Dickstein领导的研究团队于2015年首次提出扩散技术的论文《使用非平衡热力学的深度无监督学习》(Deep Unsupervised Learning Using Nonequilibrium Thermodynamics)。
原告称该论文描述了扩散过程的两个阶段:
第一阶段是通过一系列步骤逐步在图像中增加噪声,直到图像被“扩散”为随机的噪声。
第二阶段与第一阶段相反,在经历许多步骤,将某个图像转化为噪声的过程后,程序可以反向执行这些步骤,通过去除噪声,模型将生成原始图像的副本。
原告认为可以得出这样的事实:
①扩散是机器学习模型计算如何重建一个其训练图像的副本。对于每个训练图像,扩散模型会通过一系列去噪步骤,以重建特定图像,扩散模型能够重建每个训练图像的副本。扩散模型的主要目标是重建最大限度地准确和忠实于训练数据的副本图像。
②但同时原告又承认,这些重建的副本与原件并不完全一致(这也是法官指出的原告关于“压缩副本”理论的自相矛盾之处)。原告进一步阐述,在计算机术语中,它被称为有损副本,意思是当数据被压缩成一个更小的文件时,一些微小或无关紧要的细节可能会丢失,如MP3和JPEG也是通过省略少量数据来制作高度压缩的数字数据副本,也被称为“有损压缩”技术,而扩散模型是对训练图像进行有损压缩的一种形式。
③一个“训练有素”的扩散模型可以生成其任何训练图像副本的数量可能高达数十亿,因此扩散模型可以被认为是存储这些图像副本的另一种方式。就好比在你的电脑上有一个包含数十亿JPEG图像文件的目录,扩散模型则是使用统计和数学方法来存储这些数据,以更加高效和压缩的方式获取图像。
(2)原告引用的另一篇论文是Jonathan Ho研究团队的《去噪扩散概率模型》(Denoising Diffusion Probabilistic Models)论文。据原告描述,该论文说明了 "渐进式有损压缩",即一种可以使扩散模型更有效地存储其训练数据,而不会影响其重建高质量训练数据副本的方法。
原告还引用了其他文献来说明模型生成的图像必然是衍生作品,因篇幅有限笔者不再引用。总之,原告认为被告的产品就是“21世纪的拼贴工具”。
然而,原告关于“21世纪的拼贴工具”的论述也被很多人诟病,他们认为原告及代理律师没有搞清技术原理,存在很多对概念的错误理解。
根据现有的资料,扩散模型的生成过程是基于一个初始的噪声信号,通过多次迭代的扩散和反扩散操作逐渐生成图像。这个生成过程是通过学习数据的统计分布来完成的,从技术原理上解释,可能也难以被认定为存储了训练数据。
原告在诉状中对“模型以压缩副本方式存储训练数据”的论述,也许在技术理解确实存在一些缺陷,正如法官在裁定中说明的,原告不能就“压缩副本”的相关理论论述清楚,现阶段将驳回原告的相关诉请。
2.从DeviantArt违反用户协议,看WPS将用户上传数据用于AI产品训练
近日有网友提出,国内知名文字处理办公产品WPS在其隐私政策中约定,“产品将在对用户主动上传的文档材料,在采取安全和技术措施后用于AI训练的基础材料使用”
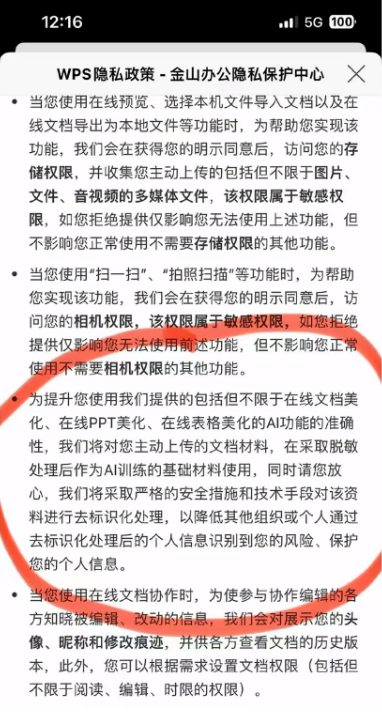
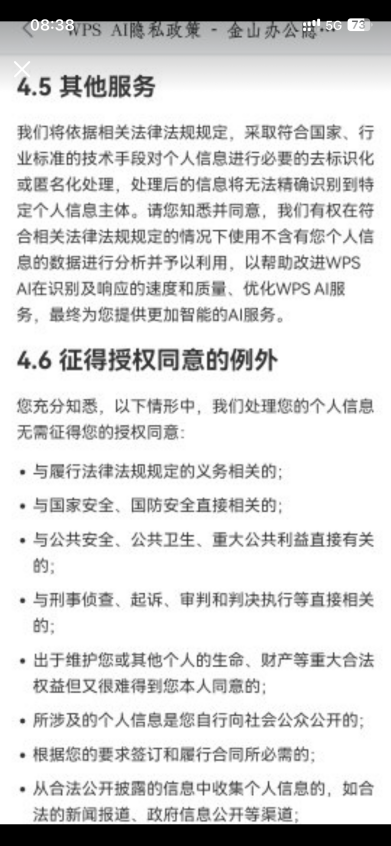
(图片来源于网络,在最新版的隐私政策中已无法找到该条款)
WPS的用户协议与DeviantArt这样的艺术社区的做法存在共通之处,也存在不同之处。共通之处是用户都会将其个人作品上传至云端或平台,且产品或平台开发者均享有一定的控制权;不同之处在于,用户对其上传的数据在某种程度上的公开或利用的主观意愿不同,DeviantArt的用户希望自己的作品被公开和在用户协议允许范围内被利用,但WPS的用户很大程度上希望这些文档被完全保密,因为这些文档往往是商业文档(最起码笔者就是这样的心态)。
海量的数据对大模型开发训练的重要性不言而喻,但如果AI产品开发者霸道地将用户数据直接用于训练AI,不仅可能引发广大用户的奋起反抗,更应当警惕其中可能引发的训练数据来源合法性风险。
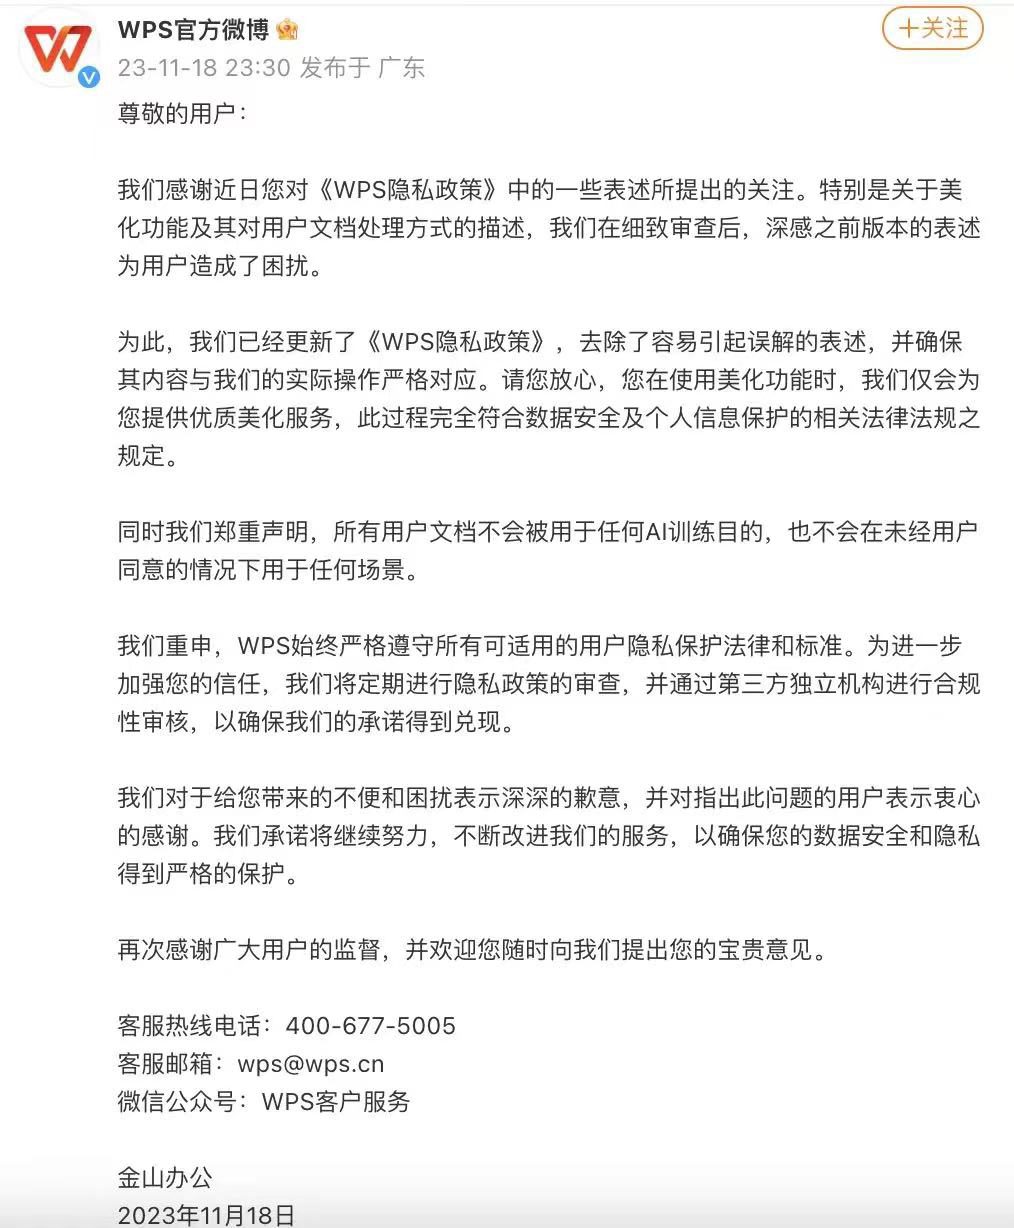
其实,平台用户协议的“霸王条款”和平台方的紧急道歉,都已经不是第一次了。且不说之前风口浪尖的“妙鸭相机”,11月18日WPS官方同样紧急进行了道歉:“我们郑重声明,所有用户文档不会被用于任何AI训练目的,也不会在未经用户同意的情况下用于任何场景。”
由于立法时间相对较早等原因,《个人信息保护法》并未将用于模型训练的数据纳入“单独同意”的范畴,但如果DeviantArt、WPS这样的文件处理平台需要将个人文档甚至商业文档纳入AI训练素材,仅凭用户协议程度的“告知同意”+“去标识化”的承诺,恐怕不足以缓解公众对于信息泄露的恐慌。将于2023年12月1日施行的《信息安全技术 个人信息处理中告知和同意的实施指南》(GB/T 42574-2023)第9.3.1款亦明确,实施通常属于可能对个人权益带来重大影响的个人信息处理活动,也需要征得个人的单独同意。将个人文档或作品用于AI训练,明显属于前述“可能对个人权益带来重大影响的个人信息处理活动”。因此,平台方在将用户的素材用于AI语料库前,宜适用高于法定义务标准的“单独同意”规范,在获得用户的充分同意和授权后,再将用户的素材用于AI训练,才能最大限度增大用户的安全感,放心地使用智能产品。
所以,WPS、妙鸭相机和DeviantArt的经验教训告诉我们,是时候把用户素材用于AI训练前的“单独同意”,做到自己的合规流程中去了。
作者简介
陈 焕 律师
陈焕律师,北京市隆安(广州)律师事务所律师、隆安湾区人工智能法律研究中心主任、隆安广州数字经济部副部长、国家工业信息安全发展研究中心《生成式人工智能数据应用合规指南》团体标准起草人。
陈焕律师在知识产权和合规领域拥有多年实务经验,在人工智能生成内容的知识产权和合规生成式人工智能治理研究、网络游戏刑事合规研究等领域著有多篇实务文章。在办案实践中成功将AI工具、爬虫技术、哈希值比对等技术手段应用于案件中,取得理想的法律效果。曾代理多件互联网、计算机有关案件 (曾获广州律协2022年度业务成果奖),如冒用微码邓白氏公司开发者“D-U-N-S”编号系列案、某音乐APP入侵计算机案、某微信小程序侵权案、某国内一线明星经纪代理纠纷、多起知名国际文旅品牌知识产权维权案等,同时为多家企业和学术机构提供数据合规建议。
李琪瑶 律师
李琪瑶律师,华南理工大学法律硕士研究生,英语专业八级。现为北京市隆安(广州)律师事务所律师,隆安湾区人工智能法律研究中心研究员。李琪瑶律师具有上市公司法务及知识产权代理机构经验,专注于知识产权领域理论研究与实务。
擅长处理商标、著作权、不正当竞争等知识产权诉讼和非诉业务、民商事争议解决及企业法律事务。曾代理邓白氏码冒用系列案、QSV解析软件不正当竞争案、某微信小程序爬虫著作权侵权案、多起知名国际文旅品牌商标维权案等案件,同时为多家企业和学术机构提供法律服务。