OpenAI爬虫频繁爬取导致人体3D模型网站瘫痪
Triplegangers是一家拥有大量人体模型扫描3D图像数据库的乌克兰公司,主要面向3D艺术家、视频游戏制作者以及任何需要以数字方式重现真实人类特征的群体出售3D文件。
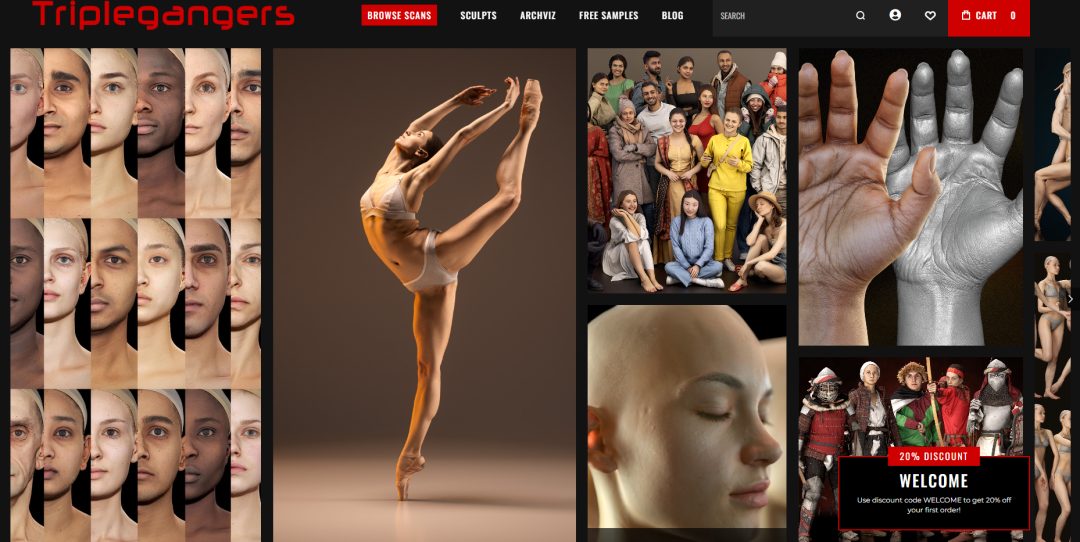
近日,该公司遭遇了一场突如其来的网站瘫痪,背后凶手竟是全球知名的OpenAI公司,OpenAI的爬虫机器人GPTBot 正在无情地爬取他们整个网站的内容。
该公司注意到,OpenAI发送了数万个服务器请求,试图下载网站的所有内容,包括数十万张照片及其详细说明。
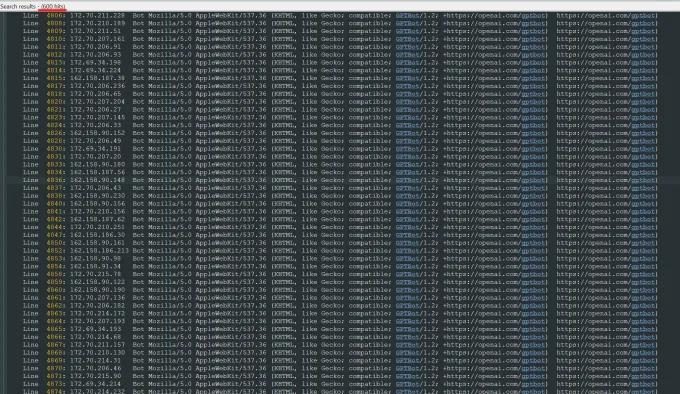
Triplegangers的CEO表示,OpenAI使用了600个IP来抓取数据,他们分析此前的后台日志后发现,可能OpenAI实际上使用更多的IP地址来爬取网站内容。OpenAI的爬虫正在破坏我们的网站,更像是一次DDoS攻击(分布式拒绝服务攻击)了。
OpenAI爬虫的行为不仅导致Triplegangers的网站无法正常运营,还可能给该公司带来巨额的云计算服务账单。
在本次网站瘫痪前,Triplegangers并没有网站缺乏有效的防护措施,仅在网站的服务条款页面载明“禁止爬虫机器人在未经许可的情况下爬取其数据。
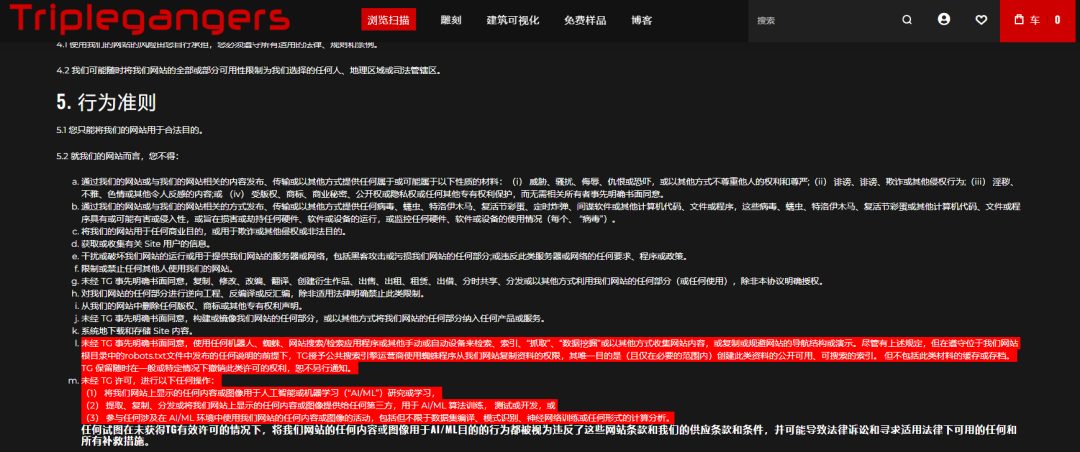
从网站瘫痪的结果来看,很明显仅仅在服务条款中声明禁止是没用的。那么,网站应该如何禁止OpenAI的爬虫机器人?
OpenAI的爬虫机器人是否会爬取你的数据来训练AI?
根据OpenAI平台的爬虫概述,OpenAI展示了OAI-SearchBot、ChatGPT-User和GPTBot三类爬虫机器人。
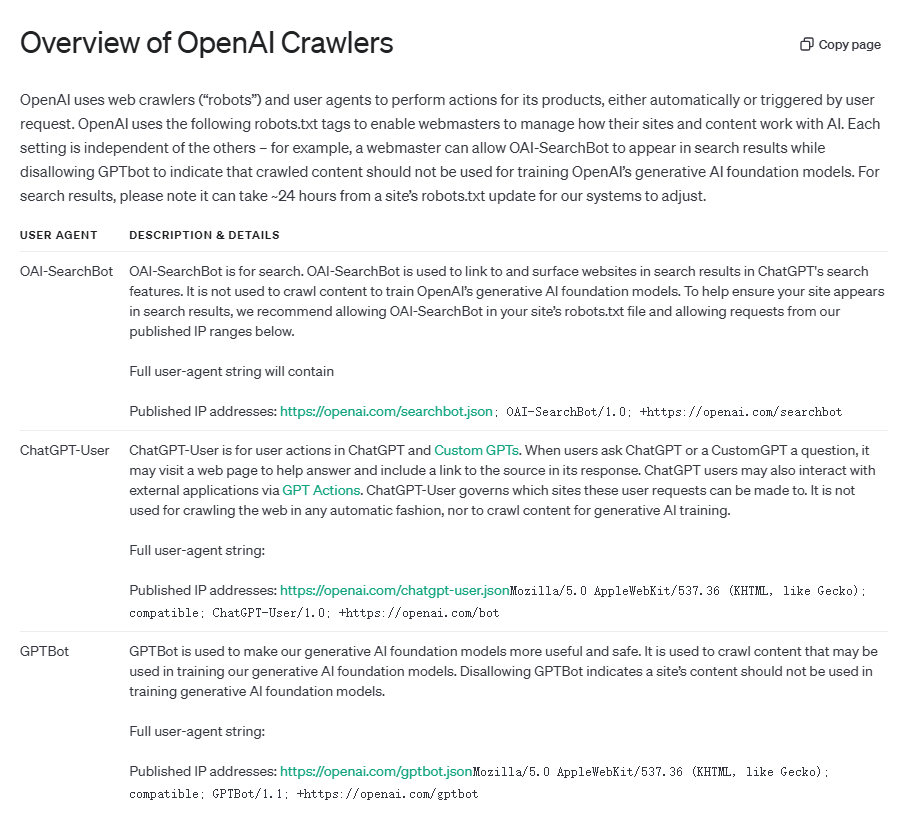
OpenAI 爬虫机器人|爬虫机器人和细节
OAI-SearchBot|OAI-SearchBot用于搜索。 OAI-SearchBot用于在ChatGPT的搜索功能中链接到网站并在搜索结果中展示。OAI-SearchBot不用于爬取内容以训练OpenAI的生成式人工智能基础模型。
ChatGPT-User|ChatGPT-User用于ChatGPT和自定义GPT中的用户操作。 当用户向ChatGPT或自定义GPT提问时,它可能会访问网页以帮助回答,并在其响应中包含来源链接。ChatGPT用户还可能通过GPT操作与外部应用程序互动。ChatGPT-User管理这些用户请求可以发送到哪些网站。ChatGPT-User不用于以任何自动方式爬取网络,也不用于爬取生成式AI训练内容。
GPTBot|GPTBot的用途为使我们的生成式人工智能基础模型更加有效和安全。GPTBot用于爬取可能用于训练我们生成式AI基础模型的内容。对于禁止GPTBot爬取的网站内容,则不应用于训练生成式AI基础模型。
可以看出,在以上三种爬虫中,OAI-SearchBot和ChatGPT-User仅用于向用户展示检索结果和问答来源展示等,不会将爬取内容用于OpenAI的模型训练。GPTBot则主要用于爬取数据来训OpenAI的模型。如果网站配置禁止GPTBot爬取,理论上GPTBot应停止访问该网站。
robots协议作为互联网行业惯例,能够指导网络爬虫如何爬取和索引网站内容。如果网站不想GPTBot访问网站的全部内容,可以将以下代码添加到robots协议中:
User-agent: GPTBot
Disallow: /
如果仅是通在网站的服务条款中禁止GPTBot爬虫,像Triplegangers公司一样,GPTBot可能无法识别。
但需要注意的是,即便网站更新了robots协议来禁止OpenAI的爬虫,OpenAI的系统可能需要24小时才能才能进行更新调整,识别到网站的禁止行为,不再爬取网站内容。
Triplegangers公司的CEO认为,这些AI公司似乎在钻漏洞,声称网站可以通过robots协议来选择退出被爬取,但实际上AI公司把责任转移到网站身上,网站运营者必须了解如何屏蔽不同的爬虫机器人。
警惕爬取大模型训练数据的法律风险
根据我国的法律规定和司法实践,未经许可爬取大模型训练数据,如爬取数据涉及受版权保护的内容、个人信息等,则可能侵犯他人的著作权和个人信息安全。此外,与一般的企业间网络爬虫行为不同,爬取数据用于AI训练是否构成不正当竞争也有待在理论和实践中进一步探讨。
本次OpenAI爬虫攻击事件给AI模型公司敲响了警钟,在关于爬取AI训练数据的监管尚未明朗的当下,企业仍应当遵循行业惯例和商业规则,尊重和保护他人的合法权益,避免侵犯知识产权、个人信息安全、商业秘密等,关注训练数据来源的合法合规。
---
作者简介
陈 焕 律师
陈焕律师,《法律人ChatGPT应用指南》作者,北京市隆安(广州)律师事务所律师、隆安湾区人工智能法律研究中心主任、隆安广州数字经济部副部长、广东财经大学法学院人工智能法研究中心兼职研究员、国家工业信息安全发展研究中心《生成式人工智能数据应用合规指南》标准起草人、广州市涉外律师领军人才。
李琪瑶 律师
李琪瑶律师,英语专业八级。现为北京市隆安(广州)律师事务所律师,隆安湾区人工智能法律研究中心研究员。李琪瑶律师擅长人工智能、数据合规、知识产权诉讼和非诉业务、民商事争议解决事务。
---
「AI合规圈」往期文章推荐:
人工智能
三问“中国AI生成物可版权性第二案”
驳回起诉:OpenAI暂时击败了新闻媒体关于AI训练的版权诉讼|附原文和翻译
AI开始关心你的便便,挂上摄像头的马桶,要不要来一个?
爱,死亡,与AI:一个因AI而死的少年
可以控制电脑的Claude3.5,离自己上班还有多远
AI搜索还能不能行了?
拥有钢铁侠的“钞能力”:想知道这个人的名字,看眼镜就行?
Adobe:推出新应用帮助用户拒绝内容用于训练AI模型
德国法院:使用摄影作品训练AI模型不构成侵权
帮你写简历?LinkedIn是如何使用你的个人信息的
加州通过两项法案,保护演员的肖像不被AI模仿
任天堂与宝可梦公司对《幻兽帕鲁》提起专利诉讼
《人工智能生成合成内容标识办法(征求意见稿)》公开征求意见的通知
中国人工智能监管及政策文件汇编
重磅:网安标委颁布《人工智能安全治理框架》1.0版
360儿童手表陷“辱华”风波,儿童智能设备如何做好合规?
利用AI换脸技术破解实名验证,太刑了
最新消息:理想已经报警。AI云诊产品有哪些合规要点?
赛博“照妖镜”:AI魑魅的标识与辨别
秘塔AI:完蛋!我们收到了知网28页的侵权告知函
检察院发文提示人工智能合规问题 | 企业如何防控刑事风险
写给法律人/程序员:与AI“开源协议”有关的5个核心问题
最新消息:理想已经报警。AI云诊产品有哪些合规要点?
赛博“照妖镜”:AI魑魅的标识与辨别
秘塔AI:完蛋!我们收到了知网28页的侵权告知函
不用考证的赛博心理咨询师,有哪些必须做的合规要点?
大模型厂商使用用户输入信息训练AI的合规策略
律师测评 | 用户创建AI虚拟人角色,平台有哪些责任?
寡姐要告OpenAI:律师评山寨名人声音的商业模式
律师测评 | ChatGPT-4o,让人机之恋走进现实
AI生成声音第一案,给AIGC创业项目的3点教训
律师评测 | 华为手机“AI一键脱衣”
数字经济
政府补贴|数据资源入表/人工智能算法备案奖励政策梳理(附原文|广州)
双十一,手可以剁,但千万不可以抖|开屏摇一摇
数据资产 | 数据资源入表,到底应该如何开展工作?
最新发布:《网络数据安全管理条例》1月1日起施行
写在3季度结束前:已有41家上市公司披露数据资源入表情况
最新发布:粤港澳大湾区(内地、澳门)个人信息跨境流动标准合同实施指引
人民法院报:虚拟货币司法处置须规范化
全国首案:《数据知识产权登记证》案的几点启发
喝咖啡前,要如何“走流程”?小程序监管已来
数据资产 | 如何在农业领域发挥数据要素乘数效应
数据资产 | 公交领域数据入表案例盘点与分析
数据圆桌|数字化智能化改造最新税收优惠政策解读
醒醒吧!虚拟币征税=交易合法?
限期实缴制下出资新方式探索——数据“入表+入股”是否具有可行性?
数据资产新篇章丨隆安广州“数据资源入表实战沙龙”在南沙圆满落幕
数据资产|对企业而言,数据资源入表有6大价值
数据合规 | 家长们最在意的“青少年模式”如何做好合规?
影响数字经济领域的指导案例发布,虚拟币交易的未来何去何从?
数据产权规定汇编|国家数据局将推出8项制度文件,涉及人工智能和数据产权
观点汇编 | 数据权益的保护路径
新书资讯
诚邀参编|全新司法解释下侵权责任编实务问答新书
通知查收|《工程老板必备法律锦囊》出书共创群
重磅推荐:《网络犯罪办案实务指南》新书上市
---
《法律人ChatGPT应用指南》,可直接点击下图购买: